الگوریتم جستجوی دودویی
مقدمه: الگوریتم جستجوی دودویی چیه؟ فرض کن توی یه فروشگاه اینترنتی، قیمت ده هزار محصول رو از ارزون ترین تا گرون ترین مرتب کردی. حالا دنبال اولین محصولی می گردی که قیمتش به پنج میلیون تومن رسیده. می تونی از اول لیست دونه دونه جلو بری، ولی یه راه خیلی باهوش تر هم داری: برو […]

مقدمه: الگوریتم جستجوی دودویی چیه؟
فرض کن توی یه فروشگاه اینترنتی، قیمت ده هزار محصول رو از ارزون ترین تا گرون ترین مرتب کردی. حالا دنبال اولین محصولی می گردی که قیمتش به پنج میلیون تومن رسیده. می تونی از اول لیست دونه دونه جلو بری، ولی یه راه خیلی باهوش تر هم داری: برو وسط لیست، قیمت رو نگاه کن و همون لحظه نصف گزینه ها رو کنار بذار. دقیقا اینجاست که الگوریتم جستجوی دودویی به دردت می خوره.
ببین، من نمی خوام فقط یه تکه کد حفظ کنی و بری سراغ درس بعدی. می خوام وقتی یک لیست بزرگ دیدی، خودت تشخیص بدی که جستجوی دودویی مناسبه یا نه، چطوری باید اجراش کنی و کجاها ممکنه جواب اشتباه بگیری. توی این آموزش با مثال تصویری شروع می کنیم، بعد با پایتون، دارت و روبی کدنویسی می کنیم، چند خطای مهم رو بررسی می کنیم و آخرش به سراغ ابزارهای آماده زبان ها می ریم.
اگه هنوز با جستجوی ساده آشنا نیستی، اول یه نگاه به آموزش الگوریتم جستجوی خطی بنداز. یاد گرفتن جستجوی دودویی بعد از جستجوی خطی خیلی شیرین تره، چون تفاوت تعداد مقایسه ها رو واقعا می بینی.
جواب کوتاه سؤال اصلی اینه: الگوریتم جستجوی دودویی یا Binary Search روشی برای پیدا کردن مقدار در داده های مرتب شده است که با هر مقایسه، تقریبا نصف بازه باقی مانده را حذف می کنه. برای آرایه معمولی با دسترسی مستقیم به عنصر وسط، زمان جستجو در بدترین حالت O(log n) و حافظه نسخه حلقه ای O(1) هست. الان با مثال می گم این جمله دقیقا یعنی چی.
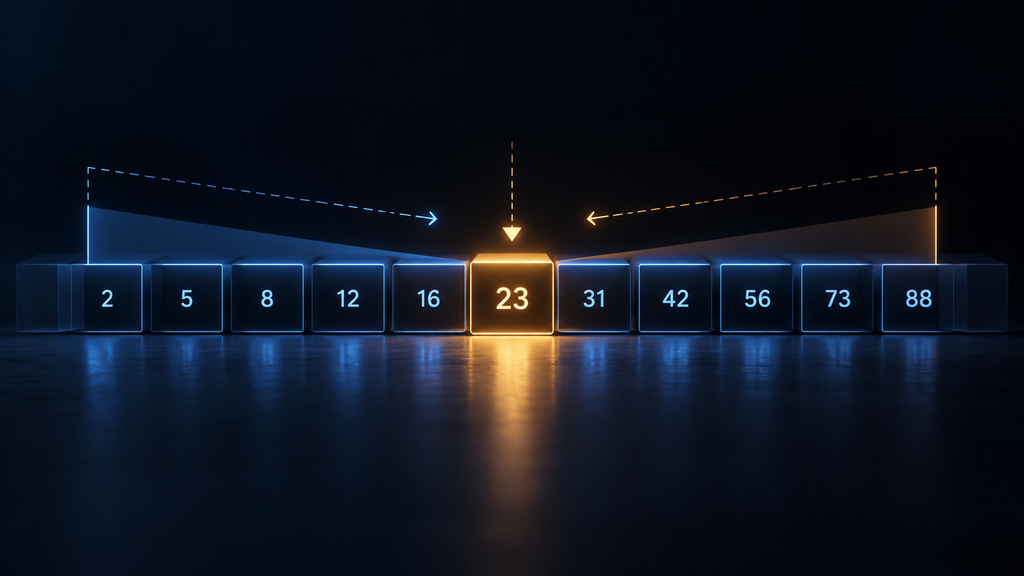
جستجوی دودویی چطوری کار می کنه؟
بیا از ساده ترین شکل شروع کنیم. فرض کن این عددها رو به ترتیب صعودی داریم: [2, 5, 7, 9, 13, 17, 21, 25, 29, 33, 37]. هدفمون پیدا کردن عدد 25 هست. توی جستجوی دودویی به سه تا موقعیت نیاز داریم: low یعنی شروع محدوده، high یعنی پایان محدوده و mid یعنی وسط همون محدوده.
قدم اول وسط لیست رو می بینیم. عدد وسط 17 هست و چون 25 بزرگ تره، می فهمیم که هیچ کدوم از عددهای سمت چپ، جواب نیستن. پس جستجو فقط در سمت راست ادامه پیدا می کنه. قدم دوم وسط قسمت باقی مونده می شه 29. این یکی از هدف بزرگ تره، پس نیمه راست رو کنار می ذاریم. قدم سوم به 21 می رسیم و سراغ سمت راست می ریم. قدم چهارم هم عدد 25 رو پیدا می کنیم؛ جایگاهش در آرایه، ایندکس 7 هست.
یادت باشه ایندکس در پایتون، دارت و روبی از صفر شروع می شه. بنابراین ایندکس 7 یعنی هشتمین عضو لیست، نه هفتمین. خیلی از خطاهای الگوریتم جستجوی دودویی فقط از همین تفاوت ساده میان.
ردگیری ۴ مقایسه تا پیدا کردن جواب
| مرحله | محدوده low تا high | عدد وسط | تصمیم |
|---|---|---|---|
| ۱ | ۰ تا ۱۰ | ۱۷ | هدف بزرگ تره؛ سمت چپ حذف می شه |
| ۲ | ۶ تا ۱۰ | ۲۹ | هدف کوچک تره؛ سمت راست حذف می شه |
| ۳ | ۶ تا ۷ | ۲۱ | سمت راست رو نگه می داریم |
| ۴ | ۷ تا ۷ | ۲۵ | پیدا شد؛ ایندکس ۷ |
حالا یه لحظه به همین جدول نگاه کن. از بین یازده عدد، فقط چهار تا عدد بررسی شد. این قدرت Binary Search هست. البته برای این نتیجه، کل لیست باید از قبل مرتب شده باشه. اگه وسط لیست رو نگاه کنی ولی ترتیب عددها معلوم نباشه، دیگه حق نداری با خیال راحت نصف لیست رو حذف کنی.
توی نسخه کلاسیک الگوریتم جستجوی دودویی، سه حالت داریم: عدد وسط دقیقا همون هدفه و کار تموم می شه؛ عدد وسط کوچک تر از هدفه و شروع محدوده رو به بعد از وسط می بریم؛ یا عدد وسط بزرگ تره و انتهای محدوده رو به قبل از وسط می بریم. شرط ادامه هم اینه که low <= high باشه. وقتی low از high رد شد، یعنی چیزی پیدا نکردیم.
شرط اصلی Binary Search: لیست باید مرتب باشه
این مهم ترین نکته کل درس هست. الگوریتم جستجوی دودویی روی آرایه ای که ترتیبش معلوم نیست، تضمین درستی نداره. مثلا لیست [10, 2, 30, 7, 18] رو در نظر بگیر. اگه دنبال عدد 10 بگردی و از عنصر وسط یعنی 30 نتیجه بگیری که جواب فقط سمت چپ قرار داره، این بار شاید شانسی جواب بگیری؛ ولی این تصمیم بر اساس نظم داده نیست و برای هدف های دیگه خیلی راحت اشتباه می شه.
در عوض، روی داده مرتب مثل [2, 7, 10, 18, 30] قانون مشخصه: هر عدد سمت راست، بزرگ تر یا مساوی عدد وسطه و هر عدد سمت چپ، کوچک تر یا مساوی اونه. پس می تونی قسمت اشتباه رو با اطمینان کنار بذاری. البته اگر لیست نزولی مرتب شده باشه، باید جهت مقایسه ها رو برعکس کنی.
یه سؤال طبیعی اینه: «خب اول داده ها رو مرتب می کنم و بعد جستجوی دودویی انجام می دم؛ مشکل چیه؟» جوابش اینه که هزینه مرتب کردن رو هم باید حساب کنی. برای یک جستجوی تکی در یک لیست نامرتب، مرتب کردن با O(n log n) و بعد جستجو با O(log n) ممکنه به صرفه نباشه. ولی اگه یک بار مرتب کنی و قرار باشه هزار بار داخل همون داده جستجو کنی، قضیه فرق می کنه.
این دقیقا همون جاییه که یاد گرفتن الگوریتم ارزش پیدا می کنه: فقط بلد بودن دستورها کافی نیست؛ باید هزینه کاری که داری انجام می دی رو هم بفهمی.
جستجوی دودویی در پایتون؛ از صفر تا اجرای کد
بریم سراغ کدنویسی. من نسخه حلقه ای رو اول انتخاب کردم، چون نسبت به روش بازگشتی راحت تر می شه مرحله به مرحله دیباگش کرد و حافظه اضافی ثابتی می خواد. این مثال جستجوی دودویی در پایتون روی لیست صعودی کار می کنه و اگه عدد پیدا نشه، مقدار -1 می ده.
یک نکته مهم برای شروع پایتون: باید با list، شرط if و حلقه while آشنا باشی. اگه هنوز این بخش ها رو راحت نیستی، توی آموزش های رایگان پایتون از همین مفاهیم پایه شروع کن.
def binary_search(values, target):
    low = 0
    high = len(values) - 1

    while low <= high:
        mid = low + (high - low) // 2
        current = values[mid]

        if current == target:
            return mid
        if current < target:
            low = mid + 1
        else:
            high = mid - 1

    return -1


numbers = [2, 5, 7, 9, 13, 17, 21, 25, 29, 33, 37]
print(binary_search(numbers, 25))
print(binary_search(numbers, 26))
این کد وقتی اجرا بشه اول 7 رو چاپ می کنه و بعد -1. چرا؟ چون ۲۵ داخل لیست هست، ولی ۲۶ نیست. دقت کن تابع از عددهای لیست چیزی کم نمی کنه و خود آرایه رو هم تغییر نمی ده؛ فقط مرز جستجو رو جابجا می کنه.
بخش mid = low + (high - low) // 2 همون پیدا کردن وسطه. توی پایتون استفاده از (low + high) // 2 هم برای عددهای معمولی مشکلی ایجاد نمی کنه، چون عدد صحیح پایتون ظرفیت ثابت نداره. ولی شکل اول برای زبان هایی که امکان سرریز عدد صحیح دارن هم الگوی امن تریه؛ برای همین عمدا همین روش رو انتخاب کردم.
حالا یه تمرین کوچیک: عدد هدف رو بذار 2، بعد 37 و بعد 100. قبل از اجرا حدس بزن خروجی چی می شه. اگه با هر سه حالت راحت بودی، تازه می تونیم بریم سراغ بخش جذاب تر جستجوی دودویی در پایتون.
چطور تمام مراحل جستجو رو در ترمینال ببینیم؟
بعضی وقت ها کد درست کار می کنه، ولی ذهن هنوز نمی فهمه چطور به جواب رسیدیم. برای همین این نسخه رو نوشتم که در هر دور مقدار low، mid و high رو چاپ کنه. وقتی داری الگوریتم رو یاد می گیری، این کار از ده بار خوندن توضیح مفیدتره.
def trace_binary_search(values, target):
    low, high = 0, len(values) - 1
    step = 0

    while low <= high:
        step += 1
        mid = low + (high - low) // 2
        print(f"step={step} low={low} mid={mid} high={high} value={values[mid]}")

        if values[mid] == target:
            return mid
        if values[mid] < target:
            low = mid + 1
        else:
            high = mid - 1

    return -1


values = [2, 5, 7, 9, 13, 17, 21, 25, 29, 33, 37]
print("index:", trace_binary_search(values, 25))
این خروجی چهار مرحله رو نشون می ده. دفعه بعد که خواستی یک الگوریتم دیگه یاد بگیری، همین کار رو بکن: تغییر مقدار متغیرهای مهم رو چاپ کن. این مدل فکر کردن فقط برای الگوریتم جستجوی دودویی نیست؛ توی ساخت API، بررسی لاگ سرور، دیباگ برنامه Flutter و حتی تحلیل برنامه های امنیتی هم واقعا به دردت می خوره.
جستجوی دودویی در دارت؛ همون منطق با یک زبان دیگه
اگه با دارت کار می کنی یا می خوای توی Flutter لیست های بزرگ رو مدیریت کنی، الگوریتم جستجوی دودویی برات آشنا می شه. فرق این مثال با پایتون بیشتر در نوع متغیرها و سینتکسه؛ منطق پیدا کردن وسط و حذف کردن نیمه اشتباه دقیقا یکسانه.
این نسخه جستجوی دودویی در دارت هم مثل پایتون، ایندکس عنصر رو برمی گردونه و وقتی نتیجه ای نبود، -1 می ده. برای درک بهترش لازمه با List، تابع و حلقه آشنا باشی.
int binarySearch(List<int> values, int target) {
  var low = 0;
  var high = values.length - 1;

  while (low <= high) {
    final mid = low + (high - low) ~/ 2;
    final current = values[mid];

    if (current == target) {
      return mid;
    }
    if (current < target) {
      low = mid + 1;
    } else {
      high = mid - 1;
    }
  }

  return -1;
}

void main() {
  final numbers = <int>[2, 5, 7, 9, 13, 17, 21, 25, 29, 33, 37];
  print(binarySearch(numbers, 25));
  print(binarySearch(numbers, 26));
}
عملگر ~/ در دارت تقسیم صحیح انجام می ده؛ یعنی وقتی نتیجه تقسیم اعشاری باشه، بخش کسری رو کنار می ذاره. یادت باشه در جستجوی دودویی در دارت هم عدد وسط رو با مقدار هدف مقایسه می کنیم، نه اینکه به تعداد مشخصی از اول لیست جلو بریم.
توی پروژه Flutter ممکنه یک لیست قیمت یا یک فهرست زمانی مرتب داشته باشی. اگه از قبل بر اساس قیمت یا تاریخ مرتب شده باشه، Binary Search می تونه برای پیدا کردن موقعیت یک مقدار مناسب باشه. ولی برای جستجو داخل مجموعه نامرتب، یا پیدا کردن رکورد با شناسه یکتا، ممکنه Map انتخاب بهتری باشه. این تفاوت از خود زبان مهم تره.
اگه دوست داری همین مسیر رو جدی تر دنبال کنی، سرفصل های آموزش دارت و آموزش فلاتر رو ببین. فعلا همون مثال بالا رو اجرا کن و مطمئن شو موقعیت ها رو خودت می تونی پیش بینی کنی.
جستجوی دودویی در روبی با while
روبی هم برای یاد گرفتن الگوریتم جستجوی دودویی انتخاب خوبیه. اگه دنبال جستجوی دودویی در روبی می گردی، اول باید با آرایه و حلقه آشنا باشی. توی زبان روبی هم با یه آرایه مرتب، دو مرز و یک حلقه while همین کار رو انجام می دیم. من این مثال رو عمدا شبیه پایتون و دارت نوشتم تا تفاوت اسم متغیرها حواست رو از اصل الگوریتم پرت نکنه.
def binary_search(values, target)
  low = 0
  high = values.length - 1

  while low <= high
    mid = low + (high - low) / 2
    current = values[mid]

    return mid if current == target

    if current < target
      low = mid + 1
    else
      high = mid - 1
    end
  end

  -1
end

numbers = [2, 5, 7, 9, 13, 17, 21, 25, 29, 33, 37]
puts binary_search(numbers, 25)
puts binary_search(numbers, 26)
خروجی روبی هم 7 و -1 می شه. توی جستجوی دودویی در روبی هم برای فهمیدن نتیجه باید بدونی ایندکس از صفر شروع می شه. جالبه که با وجود تفاوت ظاهری این سه زبان، تعداد بررسی های الگوریتم یکسانه؛ چون پیچیدگی زمانی به منطق کار بستگی داره، نه اینکه اسم زبان چی باشه.
اگه توی ذهنت این سؤال هست که «کدوم زبان برای یادگیری الگوریتم بهتره؟»، جوابی که همیشه می دم اینه: با زبانی تمرین کن که سینتکسش برات آشناست. اگه تازه شروع کردی، پایتون خیلی سرراسته. اگه با اپ موبایل کار می کنی، دارت گزینه طبیعیه. اگه روبی رو برای بک اند یا اسکریپت نویسی دوست داری، همین مثال رو اونجا هم تمرین کن. برای مسیر روبی هم صفحه آموزش روبی رو گذاشتم.
حالت های مرزی که اغلب آموزش ها نمی گن
یه الگوریتم وقتی خوبه که فقط روی مثال قشنگ و مرتب کار نکنه. من همیشه کد جستجوی دودویی رو روی چند حالت مرزی هم امتحان می کنم: لیست خالی، لیست تک عضوی، مقدار اول و آخر، مقدار غایب و عددهای تکراری. کدی که فقط روی عدد وسط جواب درست می ده، هنوز قابل اعتماد نیست.
در لیست خالی، high از همون اول -1 می شه و حلقه اجرا نمی شه؛ پس جواب -1 برمی گرده. در لیست تک عضوی، همون یک عدد بررسی می شه. برای عددهای منفی هم الگوریتم هیچ مشکلی نداره، فقط ترتیب باید درست باشه.
اما داستان عدد تکراری مهم تره. فرض کن [1, 3, 3, 3, 5] داری و دنبال 3 می گردی. الگوریتم معمولی ممکنه یکی از ایندکس های 1، 2 یا 3 رو برگردونه. اگه هدف فقط وجود داشتن مقداره، اشکالی نداره. ولی اگه اولین وقوع عدد رو لازم داری، باید نسخه مخصوص lower bound رو اجرا کنی.
پیدا کردن اولین عدد تکراری با Lower Bound
توی یک فروشگاه ممکنه چند محصول قیمت یکسانی داشته باشن. اگه بخوای اولین محصول با قیمت مشخص رو پیدا کنی، ایندکس دلخواه کافی نیست. اینجاست که نسخه معروف lower_bound به کارت میاد؛ به جای متوقف شدن روی اولین تطابق، اولین موقعیت ممکن برای مقدار رو پیدا می کنیم.
def lower_bound(values, target):
    low = 0
    high = len(values)

    while low < high:
        mid = low + (high - low) // 2
        if values[mid] < target:
            low = mid + 1
        else:
            high = mid

    return low


def first_index(values, target):
    position = lower_bound(values, target)
    if position < len(values) and values[position] == target:
        return position
    return -1


numbers = [1, 3, 3, 3, 5]
print(first_index(numbers, 3))
print(first_index(numbers, 4))
خروجی این کد 1 و -1 هست. یعنی اولین عدد ۳ در جایگاه یک قرار داره و عدد ۴ اصلا وجود نداره. دقت کن خود lower_bound به تنهایی به معنی «پیدا شد» نیست؛ ممکنه فقط جای مناسبی رو برای درج مقدار پیشنهاد بده. برای تشخیص وجود مقدار، باید اون ایندکس رو هم چک کنی.
این تکنیک یکی از بخش های جدی الگوریتم جستجوی دودویی هست و بعدا توی جستجو در بازه های قیمت، فیلتر کردن داده مرتب و حل مسئله های مسابقات برنامه نویسی زیاد به چشمت می خوره.
از توابع آماده زبان ها استفاده کنیم یا خودمون بنویسیم؟
برای یادگیری، حتما یک بار الگوریتم رو خودت بنویس. ولی وقتی وارد پروژه واقعی شدی، اغلب بهتره از پیاده سازی های استاندارد استفاده کنی. هم کمتر احتمال داره در شرط های مرزی اشتباه کنی، هم کدت برای نفر بعدی قابل فهم تره.
در پایتون ماژول داخلی bisect وجود داره. نکته مهم اینه که bisect_left به طور مستقیم وجود داشتن مقدار رو گزارش نمی ده؛ ایندکس درج مناسب رو پیدا می کنه. پس اگه می خوای بدونی مقدار واقعا هست یا نه، باید عضو همون ایندکس رو مقایسه کنی. insort هم با اینکه جای درج رو سریع پیدا می کنه، برای جابجا کردن عناصر لیست هنوز ممکنه O(n) زمان لازم داشته باشه.
from bisect import bisect_left

numbers = [1, 3, 3, 3, 5, 9]
value = 3
position = bisect_left(numbers, value)
found = position < len(numbers) and numbers[position] == value

print(position)
print(found)
در دارت هم پکیج collection تابع binarySearch رو در اختیارمون می ذاره. اگه نیاز به اولین جایگاه یک مقدار داری، lowerBound هم داخل همون پکیج هست. قبل از استفاده باید وابستگی رو به پروژه اضافه کنی؛ مثلا در پروژه دارت یا فلاتر دستور زیر رو اجرا کنی:
dart pub add collectionimport 'package:collection/collection.dart';
void main() {
final numbers = <int>[1, 3, 3, 3, 5, 9];
print(binarySearch(numbers, 3));
print(lowerBound(numbers, 3));
print(binarySearch(numbers, 4));
}فقط دقت کن binarySearch در این پکیج ممکنه یکی از رخدادهای برابر رو برگردونه؛ ولی lowerBound اولین محل مناسب رو پیدا می کنه. هر دو هم فرض می کنن ورودی مطابق همان مقایسه گر، مرتب شده است. مستندات تابع binarySearch در دارت این محدودیت رو صریح گفته.
روبی هم خوشبختانه از قبل Array#bsearch_index رو داره و لازم نیست چیزی نصب کنی. اینجا دو حالتش رو می بینی: یکی دنبال ایندکس یک مقدار مشخص می گرده و دیگری اولین عضو بزرگ تر یا مساوی هدف رو پیدا می کنه.
numbers = [1, 3, 3, 3, 5, 9]

any_index = numbers.bsearch_index { |number| number <=> 3 }
first_index = numbers.bsearch_index { |number| number >= 3 }
missing = numbers.bsearch_index { |number| number <=> 4 }

p any_index
p first_index
p missing
تو روبی مقدار nil یعنی جواب پیدا نشده. این با قرارداد -1 در نمونه آموزشی ما فرق داره، ولی هر دو کاملا معتبر هستن. چیزی که مهمه اینه که توی پروژه یک قرارداد خروجی مشخص داشته باشی و همه جای برنامه همون قرارداد رو رعایت کنی.
بررسی پیچیدگی زمانی جستجوی دودویی
حالا برسیم به دلیل اصلی محبوب بودن الگوریتم جستجوی دودویی: پیچیدگی زمانی. چون در هر مرحله تقریبا نصف گزینه ها رو حذف می کنیم، تعداد مقایسه ها با اندازه لیست به کندی زیاد می شه. به این رفتار می گیم O(log n) یا به بیان دقیق تر O(log₂ n). پایه لگاریتم در نماد Big O تفاوتی در مرتبه رشد ایجاد نمی کنه.
برای مقایسه، جستجوی خطی روی آرایه نامرتب در بدترین حالت ممکنه مجبور بشه تمام n عضو رو ببینه؛ یعنی O(n). در جستجوی دودویی اگر عضو اول از همه در وسط قرار بگیره، زمان بهترین حالت O(1) هست. بدترین حالت هم O(log n) می مونه.
یه نکته ظریف که خیلی از مقاله ها ازش رد می شن اینه که این پیچیدگی برای ساختاری مثل آرایه با دسترسی مستقیم به عضو وسط معنی داره. اگر برای رسیدن به عضو وسط مجبور باشی از اول یک لیست پیوندی حرکت کنی، هزینه دسترسی هم به محاسبه اضافه می شه. پس فقط اسم الگوریتم کافی نیست؛ نوع ساختار داده هم مهمه.
مثال ساده: یک میلیون رکورد چند مقایسه می خواد؟
| تعداد داده | جستجوی خطی؛ بدترین حالت | جستجوی دودویی؛ بیشترین مقایسه |
|---|---|---|
| ۱۰ | ۱۰ | ۴ |
| ۱٬۰۰۰ | ۱٬۰۰۰ | ۱۰ |
| ۱٬۰۰۰٬۰۰۰ | ۱٬۰۰۰٬۰۰۰ | ۲۰ |
| ۱۰٬۰۰۰٬۰۰۰ | ۱۰٬۰۰۰٬۰۰۰ | ۲۴ |
این عددها فرض می کنن آرایه از قبل مرتب شده و هر مقایسه با عنصر وسط هزینه ثابتی داره. مثلا بین یک میلیون رکورد، در بدترین حالت حداکثر ۲۰ مقایسه برای پیدا کردن مقدار یا مطمئن شدن از نبودنش کافیه. قرار نیست کامپیوتر فقط ۲۰ عملیات کل انجام بده؛ منظور ۲۰ مقایسه اصلی در حلقه جستجو هست.
پس وقتی کسی می پرسه «آیا جستجوی دودویی همیشه سریع تره؟»، جواب دقیق اینه: نه برای هر مسئله ای. روی لیست خیلی کوچک، تفاوت ممکنه اصلا مهم نباشه. روی لیست نامرتب هم اول باید هزینه مرتب سازی رو حساب کنی. برای جستجوی مقدار دقیق در یک دیکشنری پایتون، دسترسی میانگین معمولا O(1) هست و شاید انتخاب مناسب تری باشه.
مقایسه جستجوی دودویی و خطی
| ویژگی | جستجوی خطی | جستجوی دودویی |
|---|---|---|
| نیاز به مرتب بودن | خیر | بله |
| بدترین زمان در آرایه | O(n) | O(log n) |
| پیاده سازی | خیلی ساده | نیازمند مدیریت مرزها |
| آرایه نامرتب کوچک | مناسب | نیازمند مرتب سازی |
| جستجوی زیاد در آرایه مرتب | معمولا کندتر | انتخاب مناسبی |
حالا فرض کن یک فروشگاه اینترنتی داری. اگر هزار محصول مرتب بر اساس قیمت داری و کاربر می خواد اولین محصولی رو ببینه که از یه قیمت خاص گرون تره، استفاده از lower_bound کاملا منطقیه. ولی اگر همون کاربر یک کد محصول یکتا وارد کرده، شاید ایندکس یا دیکشنری بر اساس شناسه محصول راه بهتر و ساده تری باشه.
این مقایسه جستجوی دودویی و خطی نشون می ده که فقط سرعت یک حلقه مهم نیست؛ شکل داده و هزینه آماده کردنش هم تاثیر داره. این مثال خیلی نزدیک به کار برنامه نویسه: الگوریتم خوب رو از روی مد روز بودن انتخاب نمی کنیم، از روی شکل داده و نیاز مسئله انتخاب می کنیم. اون موقع تازه می فهمی چرا توی مصاحبه های فنی ازت می پرسن فرق جستجوی دودویی با جستجوی خطی چیه.
کاربردهای جستجوی دودویی در پروژه های واقعی
اولین کاربرد واقعی الگوریتم جستجوی دودویی پیدا کردن مرز در فهرست مرتب شده است؛ مثلا اولین سفارش با مبلغ بالاتر از یک مقدار مشخص، اولین بازه زمانی بعد از یک ساعت خاص یا جای درج یک امتیاز در جدول مرتب. در این مدل مسئله، اصلا دنبال یک عدد خاص نیستی؛ دنبال جایی می گردی که شرط از اون نقطه به بعد برقرار می شه.
دومین کاربرد، جستجو روی جواب مسئله هست. مثلا فرض کن یک سرور فقط تا یک تعداد مشخص درخواست همزمان رو بدون افت کیفیت جواب می ده و تو در یک آزمایش کنترل شده می خوای کمترین مقدار منابع لازم برای یک بار کاری ثابت رو پیدا کنی. اگر شرط موفقیت نسبت به منابع رفتار یکنواخت داشته باشه، می تونی به جای امتحان همه مقدارها، بازه گزینه ها رو نصف کنی. دقت کن این فقط وقتی معتبره که شرط واقعا یکنواخت باشه و اندازه گیری ها هم قابل تکرار باشن.
سومین کاربرد در کتابخانه ها و ابزارهای مهندسیه. از جستجوی دودویی در دارت برای موقعیت یابی روی لیست مرتب استفاده می کنیم و در پایتون ماژول bisect همین ایده رو برای پیدا کردن جای درج به کار می بره. حتی اگر خودت هر روز binary_search ننویسی، فهم این الگو باعث می شه از توابع آماده درست استفاده کنی.

یه اصلاح علمی هم اینجا لازمه: نباید بگیم «همه دیتابیس ها جستجوی دودویی انجام می دن». موتورهای دیتابیس بر اساس نوع ایندکس و طرح اجرای کوئری ممکنه سراغ B-tree، هش، اسکن یا راه های دیگه برن. جستجوی دودویی یکی از ایده های مهم حل مسئله است، ولی قرار نیست سازوکار هر نوع جستجو در دیتابیس رو به همین یک الگوریتم تقلیل بدیم.
برای کسی که به بک اند، لینوکس یا امنیت علاقه داره، یاد گرفتن این مدل فکر کردن مفیده: به جای اجرای کورکورانه دستورها، محدوده مسئله رو کوچک کن و هر مرحله با یک آزمایش مشخص جلو برو. این روش ذهنی موقع عیب یابی هم کمکت می کنه، هرچند خود ابزارهای امنیتی لزوما از Bubble Sort یا Binary Search استفاده نمی کنن.
نسخه بازگشتی جستجوی دودویی در پایتون
تا اینجا همه مثال هامون حلقه ای بودن. ولی الگوریتم جستجوی دودویی رو می شه با بازگشت هم نوشت. مفهومش ساده است: تابع روی نصف داده باقی مانده دوباره خودش رو صدا می زنه. این مدل برای یاد گرفتن تفکر تقسیم و حل جذابه، اما در پایتون به ازای هر فراخوانی یک فریم روی پشته اضافه می شه؛ پس برخلاف نسخه حلقه ای حافظه ثابت نداره.
def binary_search_recursive(values, target, low=0, high=None):
    if high is None:
        high = len(values) - 1

    if low > high:
        return -1

    mid = low + (high - low) // 2
    if values[mid] == target:
        return mid
    if values[mid] < target:
        return binary_search_recursive(values, target, mid + 1, high)
    return binary_search_recursive(values, target, low, mid - 1)


print(binary_search_recursive([1, 3, 5, 7, 9], 7))
print(binary_search_recursive([], 7))
این نسخه برای هدف ۷ ایندکس 3 رو برمی گردونه و برای لیست خالی جواب -1 می ده. از نظر تعداد مقایسه ها همون مرتبه زمانی O(log n) رو داره، ولی حافظه پشته در بدترین حالت O(log n) هست. برای کار روزمره نسخه حلقه ای معمولا ساده تره.
جستجوی دودویی روی جواب مسئله؛ یک تمرین واقعی
این مثال یه درجه از پیدا کردن عدد در آرایه جلوتره. فرض کن یک کارگاه چاپ می خواد بدونه با چه تعداد دستگاه، سفارش 240 بسته رو تا پایان شیفت آماده می کنه. هر دستگاه در یک شیفت 30 بسته تولید می کنه و فرض کردیم سرعت همه دستگاه ها یکسانه. کوچک ترین تعداد دستگاه لازم رو چطور پیدا می کنی؟
می تونیم از ۱ شروع کنیم و دونه دونه امتحان کنیم، ولی چون با بیشتر شدن تعداد دستگاه، ظرفیت کم نمی شه، شرط ما یکنواخته. پس جستجوی دودویی روی بازه پاسخ کار می کنه. این دقیقا همون روشیه که گاهی به اسم Binary Search on Answer می بینی.
def minimum_machines(required, per_machine):
    if required <= 0:
        return 0
    if per_machine <= 0:
        raise ValueError("per_machine must be positive")

    low = 1
    high = (required + per_machine - 1) // per_machine

    while low < high:
        mid = low + (high - low) // 2
        if mid * per_machine >= required:
            high = mid
        else:
            low = mid + 1

    return low


print(minimum_machines(240, 30))
print(minimum_machines(241, 30))
خروجی برای ۲۴۰ بسته، 8 هست و برای ۲۴۱ بسته، 9. البته توی این مثال ساده با تقسیم گرد شده هم می تونیم جواب رو مستقیم حساب کنیم. هدفم اینه که فرم «پیدا کردن اولین جواب معتبر» رو یاد بگیری؛ در مسئله های پیچیده تر شاید فرمول مستقیمی نداشته باشی و همین الگوریتم بهترین راه باشه.
مزایا و معایب الگوریتم جستجوی دودویی
مزیت اول جستجوی دودویی واضحه: وقتی داده مرتب و دسترسی به عضو وسط سریع باشه، تعداد بررسی ها خیلی کمتر از جستجوی خطی می شه. مزیت دوم اینه که بدون جابجا کردن داده ها می تونی فقط موقعیت یک مقدار رو پیدا کنی. مزیت سوم هم اینکه این الگو برای پیدا کردن مرز و کمترین جواب معتبر به درد می خوره، نه فقط پیدا کردن عدد.
اما عیبش رو هم باید بشناسیم. اول اینکه داده معمولا باید مرتب باشه یا شرط جستجو رفتار یکنواخت داشته باشه. دوم اینکه نوشتن درست مرزها از یک حلقه ساده سخت تره و اشتباه های < و <= می تونن باعث جا افتادن یک عضو یا حلقه بی پایان بشن. سوم اینکه اگر قرار باشه هر بار داده رو مرتب کنی، مزیت سرعت جستجو ممکنه از بین بره.
پس نتیجه منطقی این نیست که «از فردا همه جا Binary Search بزن». نتیجه اینه که جستجوی دودویی یک ابزار دقیق برای یک دسته مشخص از مسئله هاست؛ هر وقت شرایطش برقرار بود، خیلی قدرتمنده.
اشتباه های رایج در کدنویسی باینری سرچ
اولین اشتباه، استفاده از جستجوی دودویی روی لیست نامرتبه. دومین اشتباه، آپدیت اشتباه مرزهاست؛ مثلا وقتی مقدار وسط از هدف کوچک تره، باید low = mid + 1 بشه، نه low = mid. در حالت دوم ممکنه وسط تکرار بشه و حلقه هیچ وقت تموم نشه.
اشتباه سوم اینه که بعد از پیدا کردن یک عدد تکراری، فکر کنیم حتما اولین ایندکس رو گرفتیم. این طور نیست؛ برای اولین وقوع از روش lower_bound استفاده کن. اشتباه چهارم اینه که عدد -1 رو بی دقت به عنوان ایندکس واقعی مصرف کنیم. در پایتون values[-1] آخرین عضو لیسته، پس اگه قبلش نتیجه رو چک نکنی، برنامه به جای خطا یک داده اشتباه می ده!
اشتباه پنجم هم مربوط به جهت مرتب سازی می شه. کدهایی که بالا نوشتیم برای صعودی هستن. روی نزولی اگه علامت مقایسه رو عوض نکنی، نتایج قابل اعتماد نیستن. برای داده هایی مثل قیمت های اعشاری هم گاهی مقایسه دقیق با == مناسب نیست و باید نوع داده و دقت مورد نیاز رو بررسی کنی.
تست جستجوی دودویی؛ با حدس جلو نرو
بیا یاد بگیریم چطوری مطمئن بشیم کد الگوریتم جستجوی دودویی در پایتون درست کار می کنه. فقط یک خروجی خوب دیدن کافی نیست. چند نوع ورودی مختلف می سازیم، بعد نتیجه رو با جواب ساده ای که از قبل می دونیم مقایسه می کنیم. این تمرین توی کار واقعی خیلی مهم تر از حفظ اسم الگوریتمه.
def binary_search(values, target):
    low, high = 0, len(values) - 1
    while low <= high:
        mid = low + (high - low) // 2
        if values[mid] == target:
            return mid
        if values[mid] < target:
            low = mid + 1
        else:
            high = mid - 1
    return -1


cases = [
    ([], 5, -1),
    ([7], 7, 0),
    ([7], 3, -1),
    ([-8, -3, 0, 2, 9], -8, 0),
    ([-8, -3, 0, 2, 9], 9, 4),
    ([-8, -3, 0, 2, 9], 4, -1),
]

for values, target, expected in cases:
    assert binary_search(values, target) == expected

values = [1, 2, 2, 2, 5]
index = binary_search(values, 2)
assert index in (1, 2, 3)
print("All tests passed")
اگه همه چیز درست باشه، پیام All tests passed رو می بینی. بعدش خودت دو تست اضافه کن: یکی لیست نزولی با تابع مخصوص نزولی، یکی لیست ده هزار عضوی. اگه می خوای وارد برنامه نویسی حرفه ای بشی، تمرین نوشتن تست از یاد گرفتن یک دستور جدید کم ارزش تر نیست.
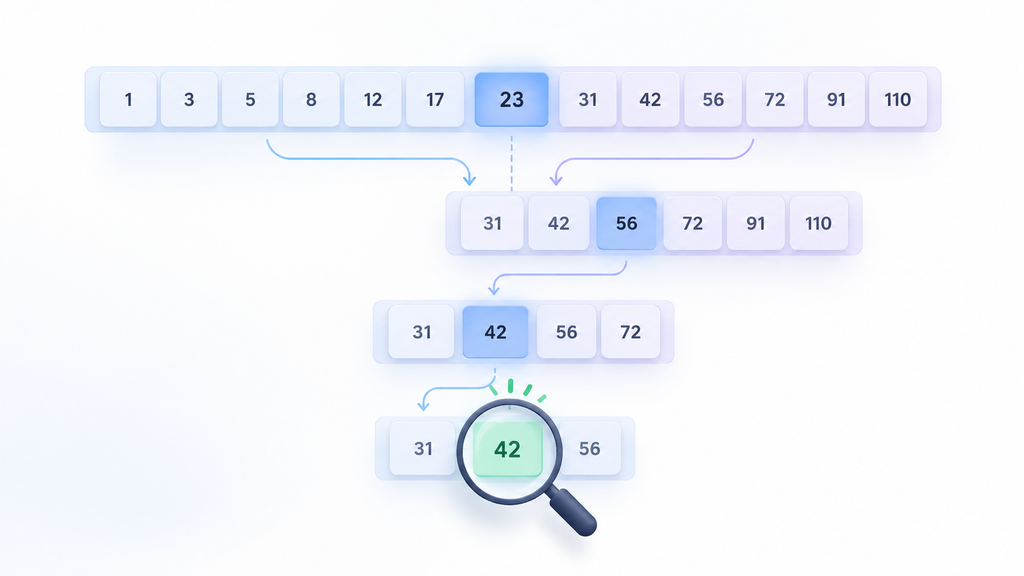
این الگوریتم رو با چه زبانی یاد بگیریم؟
اگه اولین باره الگوریتم می خونی و هنوز درگیر سینتکس زبان ها هستی، پیشنهاد من اینه با پایتون شروع کنی. جستجوی دودویی در پایتون خیلی سریع نشون می ده حلقه و شرط چطور با هم کار می کنن. اگه مسیرت ساخت اپ با Flutter هست، همون مفهوم رو در دارت تمرین کن تا بعدا توی فیلتر قیمت و مرتب سازی لیست ها سردرگم نشی. اگه روبی رو برای ساخت اسکریپت یا بک اند دنبال می کنی، نمونه روبی کمک می کنه همزمان با مفاهیم زبان هم آشنا بشی.
این موضوع رو مستقیم به درآمد و شغل وصل نکنیم. کسی فقط با بلد بودن Binary Search برنامه نویس استخدام نمی شه. اما آدمی که می فهمه چه زمانی داده باید مرتب باشه، چه زمانی لازم نیست و چطور کدش رو تست کنه، در پروژه واقعی تصمیم های بهتری می گیره. مسیر یاد گرفتن همین تصمیم هاست که ارزش داره، نه حفظ کردن صد تا تابع.
برای ادامه، می تونی تمرین های دوره پایتون، دوره دارت یا دوره روبی رو بر اساس زبانی که انتخاب کردی ببینی. اولویت من اینه که همین مثال مقاله رو کامل بفهمی، نه اینکه فقط یک کد رو کپی کنی.
سوالات متداول درباره جستجوی دودویی
الگوریتم جستجوی دودویی چیست؟
الگوریتم جستجوی دودویی یا Binary Search یک روش جستجو در داده های مرتب شده است. در هر مرحله عنصر وسط رو بررسی می کنیم و بر اساس مقایسه با هدف، نصف بازه باقی مانده رو کنار می ذاریم. زمان جستجو روی آرایه مرتب در بدترین حالت O(log n) هست.
جستجوی دودویی چه فرقی با جستجوی خطی داره؟
جستجوی خطی ممکنه مجبور بشه همه عناصر رو یکی یکی بررسی کنه و به مرتب بودن هم نیاز نداره. ولی جستجوی دودویی وقتی آرایه مرتب باشه، با هر مقایسه تقریبا نصف گزینه ها رو حذف می کنه. برای همین روی داده بزرگ و مرتب معمولا تعداد بررسی خیلی کمتری داره.
آیا جستجوی دودویی روی لیست نامرتب کار می کنه؟
نه، روی لیست نامرتب تضمین درستی نداره. ممکنه توی یک مثال تصادفا جواب درست بده، اما چون ترتیب عنصرهای سمت چپ و راست معلوم نیست، حذف کردن نصف داده قابل اعتماد نیست. اول باید درباره هزینه مرتب کردن و تعداد دفعات جستجو تصمیم بگیری.
پیچیدگی زمانی جستجوی دودویی چقدره؟
در بهترین حالت که عنصر وسط همون هدف باشه O(1) هست. در حالت معمول و بدترین حالت، تعداد مراحل از مرتبه O(log n) رشد می کنه. نسخه حلقه ای با چند متغیر ساده، حافظه اضافه O(1) می خواد.
چطور جستجوی دودویی در پایتون بنویسم؟
یک تابع با low و high بساز، در حلقه while low <= high وسط رو حساب کن و با هدف مقایسه کن. اگر برابر بود ایندکس رو بده، در غیر این صورت مرز مناسب رو تغییر بده. کد کامل و تست ها در بخش جستجوی دودویی در پایتون بالای همین مقاله هست.
جستجوی دودویی در دارت به چه دردی می خوره؟
وقتی توی دارت یا Flutter یک لیست مرتب داری و می خوای جای یک مقدار رو سریع پیدا کنی، جستجوی دودویی در دارت مناسبه. هم می تونی دستی بنویسی، هم با پکیج collection از binarySearch یا lowerBound استفاده کنی.
در روبی تابع آماده Binary Search داریم؟
بله، آرایه روبی متدهای bsearch و bsearch_index داره. اولی عنصر رو می ده و دومی ایندکس رو. باید شرط بلوک متناسب با حالت جستجو نوشته بشه و آرایه هم مرتب باشه.
Binary Search با Binary Search Tree فرق داره؟
بله. Binary Search یک الگوریتم روی یک بازه مرتب با دسترسی به عنصر وسطه. Binary Search Tree یا BST یک ساختار داده درختیه که قوانین ترتیب بین زیر درخت چپ و راست داره. شباهت اسمی دارن، اما یکی رو نباید معادل دیگری حساب کرد.
اگر عدد داخل آرایه نباشه چی می شه؟
در پیاده سازی آموزشی این مقاله، وقتی مرز low از high رد بشه تابع -1 برمی گردونه. اما توابع آماده بعضی زبان ها قرارداد متفاوتی دارن. مثلا bisect_left محل درج رو می ده و متدهای روبی ممکنه nil برگردونن.
آیا جستجوی دودویی در پایتون تابع آماده داره؟
پایتون ماژول استاندارد bisect رو داره. مثلا bisect_left با جستجوی دودویی جای مناسب درج در لیست مرتب رو پیدا می کنه. برای فهمیدن اینکه مقدار واقعا وجود داره، بعد از گرفتن ایندکس باید خود مقدار رو هم بررسی کنی.
چرا در Binary Search عدد وسط رو انتخاب می کنیم؟
چون برای داده مرتب، مقایسه با وسط اجازه می ده در یک تصمیم بخش بزرگی از گزینه ها رو حذف کنیم. انتخاب عضو اول معمولا این مزیت رو نداره. الگوریتم جستجوی دودویی در هر مرحله همین استدلال رو تکرار می کنه.
جستجوی دودویی بازگشتی بهتره یا حلقه ای؟
هر دو از نظر تعداد مقایسه ها O(log n) هستن. نسخه حلقه ای حافظه اضافه ثابت و معمولا دیباگ ساده تری داره. نسخه بازگشتی برای فهم تفکر تقسیم مسئله خوبه، اما به ازای فراخوانی ها از پشته استفاده می کنه.
آیا روی اعداد منفی هم جواب می ده؟
بله. جستجوی دودویی با عدد منفی، صفر و مثبت مشکلی نداره. فقط باید ترتیب مقایسه رو درست در نظر بگیری و لیست با همون معیار مرتب شده باشه.
اگر چند عدد تکراری داشته باشیم کدوم رو پیدا می کنه؟
نسخه معمولی ممکنه هر کدوم از ایندکس های دارای مقدار برابر رو برگردونه. اگه اولین تکرار رو لازم داری از lower_bound استفاده کن. اگر آخرین تکرار رو می خوای، باید مرز بالایی رو هم حساب کنی.
چرا lower_bound ممکنه عددی رو برگردونه که وجود نداره؟
چون کارش پیدا کردن اولین جایگاهیه که عنصر اونجا کوچک تر از هدف نیست. این جایگاه حتی اگر هدف اصلا توی لیست نباشه هم معنی داره. برای تشخیص وجود، باید محدوده ایندکس و برابری مقدار رو بررسی کنی.
چطور باینری سرچ رو با لیست نزولی انجام بدم؟
وقتی لیست از بزرگ به کوچک مرتب شده، علامت های مقایسه برای انتخاب نیمه باید برعکس بشن. کدی که برای داده صعودی نوشتیم رو بدون تغییر روی لیست نزولی اجرا نکن.
جستجوی دودویی روی رشته ها هم قابل انجامه؟
بله، اگه رشته ها رو با یک معیار مشخص مثل ترتیب الفبایی مرتب کرده باشی، می تونی همون معیار رو در جستجو استفاده کنی. نکته اینه که روش مرتب سازی و روش مقایسه باید با هم سازگار باشن.
آیا Binary Search همیشه سریع تر از Linear Search هست؟
نه. برای داده نامرتب و یک جستجوی ساده، جستجوی خطی ممکنه انتخاب بهتری باشه. وقتی داده مرتب باشه و حجم زیاد یا دفعات جستجو بالا باشه، مزیت جستجوی دودویی بیشتر خودش رو نشون می ده.
برای یک میلیون عدد چند مرحله لازم داریم؟
روی آرایه مرتب یک میلیون عضوی با مدل کلاسیک Binary Search، در بدترین حالت حدود ۲۰ مقایسه با عنصر وسط لازمه. این عدد تعداد مقایسه های اصلیه و شامل همه هزینه های ورودی، حافظه و سیستم نمی شه.
جستجوی دودویی در دیتابیس ها استفاده می شه؟
ایده جستجو روی داده مرتب در علوم کامپیوتر خیلی مهمه، ولی نمی شه گفت همه دیتابیس ها دقیقا از Binary Search روی آرایه استفاده می کنن. نوع ایندکس، موتور دیتابیس و برنامه اجرای کوئری تعیین می کنن چه روشی به کار بره.
برای پروژه واقعی بهتره دستی بنویسیم یا تابع آماده؟
برای تمرین حتما دستی بنویس تا مرزها و شرط های پایان رو بفهمی. در پروژه واقعی معمولا تابع آماده و استاندارد خواناتر و قابل اعتمادتره، به شرط اینکه قرارداد خروجی و شرط مرتب بودن رو درست رعایت کنی.
تفاوت مرتب سازی حبابی و جستجوی دودویی چیه؟
مرتب سازی حبابی یا Bubble Sort کارش مرتب کردن داده هاست. جستجوی دودویی یا Binary Search کارش پیدا کردن محل یک مقدار در داده های از قبل مرتب شده است. اگه هر دو موضوع برات جدیده، اول مرتب سازی حبابی رو بخون و بعد همین مقاله رو تمرین کن.
چه زمانی باید اول لیست رو مرتب کنیم؟
اگه قرار باشه جستجوهای زیادی روی یک مجموعه ثابت انجام بدی، مرتب کردن یک بار و بعد استفاده از جستجوی دودویی ممکنه به صرفه باشه. برای یک جستجوی تکی روی داده نامرتب، هزینه مرتب سازی رو هم باید حساب کنی.
آیا با کتابخانه های هوش مصنوعی هم باید الگوریتم بلد باشیم؟
بله، چون مسئله اصلی فقط نوشتن کد نیست؛ باید بفهمی خروجی درست هست یا نه، هزینه اجرا چقدره و چه داده هایی باعث شکست الگوریتم می شن. ابزار AI می تونه کد جستجوی دودویی بنویسه، ولی تشخیص کاربرد درستش همچنان به فهم تو نیاز داره.
بهترین زبان برای یادگیری جستجوی دودویی چیه؟
هر زبانی که اصول حلقه و شرطش رو بلدی. برای شروع، جستجوی دودویی در پایتون خیلی ساده و خواناست؛ اگر با Flutter کار می کنی دارت مناسبه و اگر روبی رو یاد می گیری هم همون منطق قابل اجراست.
چرا بعضی وقت ها حلقه بی پایان می شه؟
معمولا چون مرزها درست تغییر نکردن. وقتی مقدار وسط کوچک تر از هدفه، باید low به mid + 1 بره. اگر وسط دوباره داخل همان بازه باقی بمونه، ممکنه حلقه در یک حالت گیر کنه.
آیا جستجوی دودویی روی لیست پیوندی هم سریع هست؟
نه لزوما. مزیت O(log n) برای آرایه با دسترسی مستقیم به عنصر وسط مطرحه. در لیست پیوندی، رسیدن به عنصر وسط خودش هزینه داره، پس ممکنه روش دیگه ای مناسب تر باشه.
فرق bsearch و lower_bound چیه؟
جستجوی معمولی bsearch برای پیدا کردن یک نتیجه مطابق شرط به کار می ره؛ ولی lower_bound اولین محل ممکن برای قرار گرفتن یک مقدار در ترتیب صعودی رو پیدا می کنه. دومی برای عددهای تکراری و محدوده قیمت خیلی مفیده.
چطور الگوریتم رو برای مصاحبه برنامه نویسی تمرین کنم؟
اول نسخه حلقه ای رو بدون نگاه کردن به کد بنویس. بعد لیست خالی، مقدار پیدا نشده، اولین و آخرین عضو و تکراری ها رو تست کن. در آخر دلیل زمان O(log n) و فرقش با جستجوی خطی رو با مثال توضیح بده.
باینری سرچ به درد ساخت اپ Flutter می خوره؟
بله، وقتی توی کد دارت روی یک لیست مرتب دنبال مرز قیمت، تاریخ یا ایندکس یک مقدار هستی. البته برای هر جستجویی مناسب نیست و باید قبلش ببینی داده چطور نگهداری شده.
ویدیوی آپارات درباره کدوم الگوریتمه؟
ویدیوی پایین آموزش الگوریتم جستجوی دودویی هست و روند پیدا کردن مقدار در داده مرتب رو قدم به قدم توضیح می ده. بعد از دیدنش مثال های پایتون، دارت و روبی همین صفحه رو اجرا کن تا مفهوم توی ذهنت بشینه.
چطور بفهمم پیاده سازی Binary Search من درست هست؟
فقط روی یک مثال آزمایش نکن. تست واحد برای لیست خالی، تک عضوی، عدد منفی، ابتدا و انتهای لیست، داده غایب و عدد تکراری بنویس. بهتره نتیجه رو با یک روش ساده و قابل اطمینان هم مقایسه کنی.
نتیجه گیری
خب، حالا اگر کسی ازت پرسید الگوریتم جستجوی دودویی چیه، لازم نیست یک تعریف کتابی حفظ کنی. خیلی ساده بگو: وقتی داده ها مرتب هستن، وسط رو نگاه می کنیم و هر بار نصف گزینه ها رو کنار می ذاریم. بعد هم با یه مثال مثل پیدا کردن قیمت داخل فهرست مرتب، ایده رو نشون بده.
من پیشنهاد می کنم از بین سه زبان پایتون، دارت و روبی یکی رو انتخاب کنی، نسخه حلقه ای جستجوی دودویی رو خودت بنویسی، بعد روش پیدا کردن اولین عدد تکراری رو هم امتحان کنی. این دو تمرین خیلی بیشتر از تماشای صرف آموزش بهت یاد می دن. اگه هنوز موقع کار با حلقه و شرط به مشکل می خوری، قبل از وارد شدن به الگوریتم های سخت تر برگرد همون بخش رو محکم کن.
توی ویدیوی پایین هم خودم همین الگوریتم جستجوی دودویی رو آموزش دادم. بهتره اول یک بار روند پیدا کردن وسط و کنار گذاشتن نیمه اشتباه رو ببینی، بعد کدها رو اجرا کنی و برای هر بار جستجو حدس بزنی قدم بعدی کجاست. وقتی تونستی خودت جواب رو پیش بینی کنی، یعنی Binary Search رو واقعا یاد گرفتی.
اگه میخوای این موضوع رو جدیتر یاد بگیری، مسیر کاملش اینجاست.
دورهها موضوع رو از پایه تا اجرای واقعی، پروژه و نکتههایی که وسط کار بهشون میرسی جلو میبرن.
نظرها و تجربهها
سؤال، تجربه یا نکتهای درباره این مقاله داری؟ اینجا بنویس تا گفتوگو برای بقیه هم مفید بمونه.
پست قبلی رو حتماً مشاهده کنید. نظرتون رو حتماً بنویسید