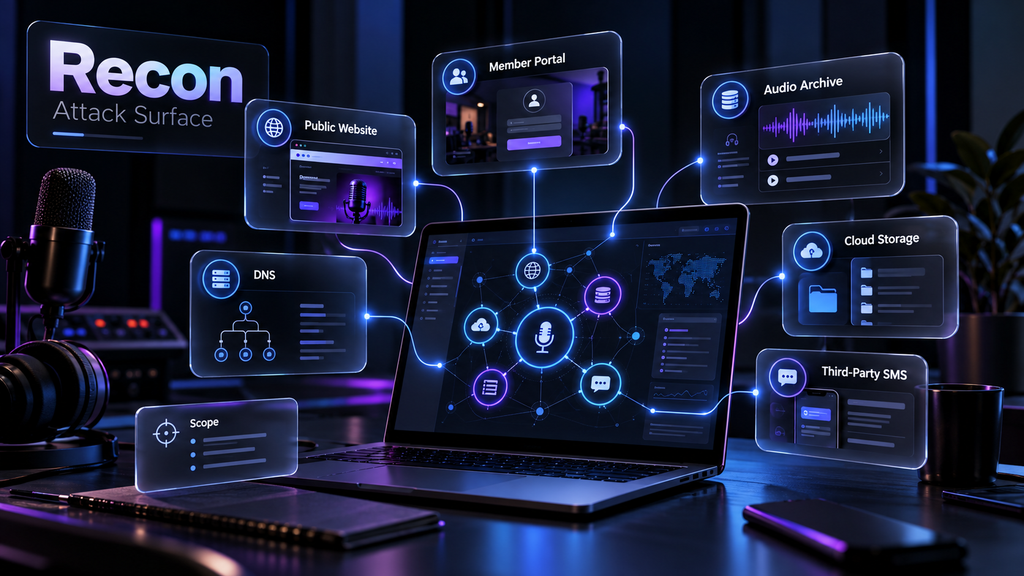
فرض کن یه استودیو پادکست ازت خواسته امنیت سامانهش رو بررسی کنی. مدیرش لپتاپ رو میچرخونه سمتت و میگه : «این آدرس سایتمونه، بقیهش با تو!» حالا تو بهجای اینکه همون لحظه Nmap رو باز کنی، یه سؤال ساده میپرسی : «همه سرویسهای شما همین یک سایتن؟» احتمالاً نه. فایلهای تدوین توی یه فضای ذخیرهسازی جدا نگهداری میشن، اعضا یه پنل مخصوص دارن، پیامک رو شرکت دیگهای میفرسته و شاید یه نسخه آزمایشی هم هنوز روشن مونده باشه. مسئله اینه که کدوم یکی از اینها واقعاً متعلق به استودیوئه و برای بررسی کدومش اجازه داری. این اطلاعات رو نمیشه از ظاهر صفحه اصلی حدس زد.
ببین، جمعآوری اطلاعات در هک دقیقاً از همین سؤالها شروع میشه. به این کار Reconnaissance یا بهاختصار Recon میگیم. توی این درس میخوام نشونت بدم چطور از چند سرنخ پراکنده به یه تصویر قابل اتکا از داراییها میرسیم، فرق شناسایی فعال و غیرفعال چیه و چرا پیدا کردن یه آدرس جدید هیچ مجوز تازهای به ما نمیده. یه استودیوی پادکست کاملاً فرضی رو تا آخر درس همراه داریم؛ تمرین پایتون هم آفلاینه و هیچ درخواست شبکهای به هدف واقعی نمیفرسته.
جمع آوری اطلاعات در هک چیست؟ تعریف Reconnaissance با مثال ساده
بذار خیلی ساده تعریفش کنیم : جمعآوری اطلاعات در هک یعنی قبل از آزمودن امنیت یک محیط، بفهمیم چه سیستمها، سرویسها، فناوریها و ارتباطهایی داخلش وجود دارن و هرکدوم چه نقشی دارن. توی تست نفوذ قانونی، این اطلاعات رو با محدوده توافقشده مقایسه میکنیم تا مشخص بشه چه چیزی اجازه بررسی داره و کدوم بخش هنوز نیازمند تأیید مالکه. هدف این مرحله پیدا کردن سرنخهای قابل بررسیه، نه اینکه صرفاً با پیدا کردن اسم یه سرور ادعا کنیم آسیبپذیره.
مثلاً میدونی استودیو دامنه اصلیش رو کجا میزبانی میکنه؛ آیا از همین میتونی نتیجه بگیری پنل تدوین همونجاست؟ نه. شاید یه سرویس ابری جداگانه باشه یا مدتها پیش جابهجا شده باشه. ممکنه یه زیردامنه در آرشیوها دیده بشه، ولی امروز دیگه وجود نداشته باشه. ارزش کار اینه که اسم پیداشده، وضعیت فعلی، مالکیت و مجوز رو چهار چیز متفاوت بدونی. یه لیست طولانی از اسمها بدون این تفکیک، بیشتر باعث اشتباه میشه تا کمک.
این نگاه به جمعآوری اطلاعات در هک فقط سلیقه من نیست. راهنمای NIST SP 800-115 شناخت و بررسی محیط رو بخشی از ارزیابی فنی میدونه و راهنمای جمعآوری اطلاعات OWASP توضیح میده که قبل از آزمون امنیت وب باید داراییها و نقاط ورود شناخته بشن. این دو منبع، چارچوب فکری خوبی بهمون میدن؛ سناریوی پادکست و مثالهای این درس ساختگی و آموزشی هستن، نه گزارشی از یه پروژه واقعی.
چرا جمعآوری اطلاعات در تست نفوذ از شناخت هدف شروع میشه؟
برای اینکه کاربرد جمعآوری اطلاعات در هک رو ببینی، فرض کن تیم تست فقط صفحه ورود سایت پادکست رو میبینه. ممکنه امکان آپلود فایل صوتی یا پنل انتشار پیشنویسها رو اصلاً نشناسه و بعد گزارش بده «چیزی پیدا نکردیم». از اون طرف، اگه هر سرویس مشابهی رو بدون بررسی مجوز وارد اسکن کنه، شاید به سامانه یه شرکت ثالث درخواست بفرسته. هر دو مشکل از یه جا میاد : هنوز نمیدونیم دقیقاً با چه محیطی طرفیم و مرز کار کجاست.
توی جمعآوری اطلاعات در هک چند سؤال رو همیشه جلوی چشم داشته باش : چه چیزی پیدا کردیم؟ اطلاعاتش از کجا اومده؟ آخرین بار کی دیده شده؟ چه ارتباطی با هدف داره؟ مالک، این ارتباط رو تأیید کرده؟ اجازه چه نوع بررسیای داریم؟ وقتی جواب اینها روشن باشه، انتخاب ابزار هم منطقیتر میشه. اونوقت بهجای اینکه بیهدف اسم دامنه جمع کنی، میدونی هر داده قراره به کدوم تصمیم امنیتی کمک کنه.
یه نکته دیگه هم هست : Recon فقط برای حملهکنندهها نیست. تیم دفاعی هم باید بدونه چه سرویسهایی به اینترنت وصلن، چه داراییهایی دیگه استفاده نمیشن و کجاها مستندات ناقصه. ممکنه یه سرویس ناشناخته فقط یه سیستم فراموششده باشه، نه یه حفره امنیتی. ولی تا وقتی وجودش ثبت نشده، تیم امنیت نمیتونه درباره نگهداری، بهروزرسانی یا خارج کردنش از مدار تصمیم درستی بگیره.
تفاوت Reconnaissance، OSINT، Footprinting و Enumeration چیه؟
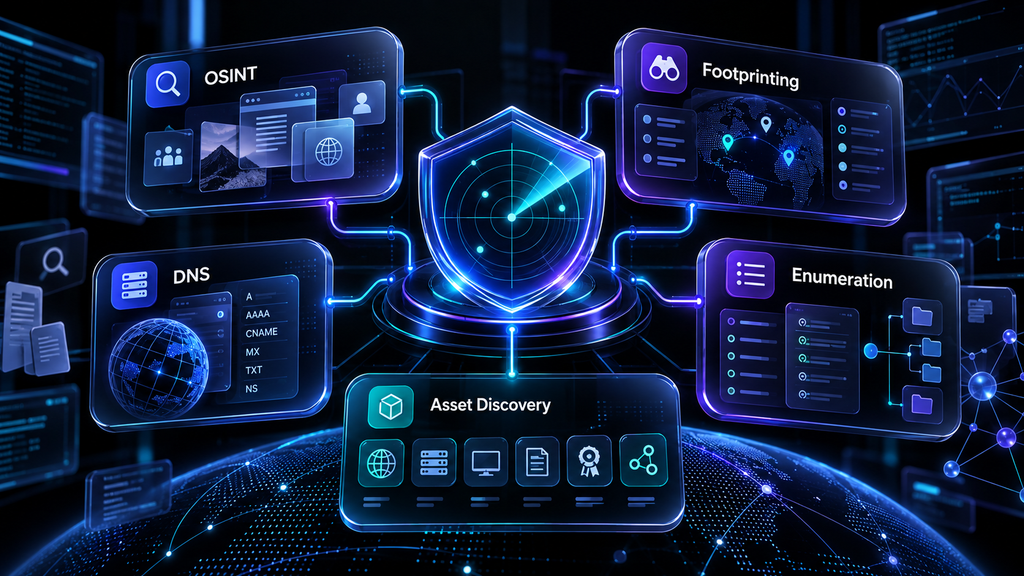
برای فهم بهتر جمعآوری اطلاعات در هک، این چهار تا اصطلاح رو احتمالاً توی آموزشها زیاد میبینی : Reconnaissance، OSINT، Footprinting و Enumeration. خیلی جاها جاشون رو بهجای هم به کار میبرن، ولی برای شروع اینطوری تفکیکشون کن : Recon اسم کلی شناخت محیطه؛ OSINT یعنی تحلیل دادههایی که از منابع عمومی یا در دسترسِ مجاز میگیری؛ اگه میپرسی «Footprinting چیست؟»، جواب کوتاهش اینه که Footprinting بیشتر به ترسیم ردپای فنی و سازمانی اشاره داره؛ Enumeration یعنی جزئیات بیشتری رو از منابع یا سرویسهای مشخص استخراج کنی. اینها دیوارهای جدا از هم نیستن و روش اجراشون ممکنه همپوشانی داشته باشه.
| اصطلاح | سؤال اصلی | مثال مفهومی |
|---|---|---|
| Reconnaissance | از محیط مورد بررسی چه میدونیم؟ | ساخت نقشه داراییها، روابط و سطح مشاهده |
| OSINT | چه اطلاعاتی در منابع عمومی قابل مشاهدهست؟ | مطالعه اطلاعات انتشاریافته و سوابق عمومی |
| Footprinting | ردپای فنی و سازمانی چطور دیده میشه؟ | پیوند نامهای دامنه، سرویسها و سازمان |
| Enumeration | از یک سرویس مجاز چه جزئیات معتبری میشه استخراج کرد؟ | شناسایی دقیقتر منابع و قابلیتها در محدوده توافق |
| Scanning | یک بررسی فنی چه سرویسها یا نشانههایی رو کشف میکنه؟ | ارزیابی محدود و برنامهریزیشده وضعیت سرویسها |
پس جمع آوری اطلاعات در هک لزوماً از یه اسکن شبکه شروع نمیشه. شاید اول فقط معماریای رو که مالک تحویلت داده بخونی، نقش سرویسها رو مشخص کنی و درباره چند دامنه نامعلوم سؤال بپرسی. تازه بعدش، اگه مجوز داشته باشی، از روشهای فعال استفاده میکنی. این رو با اسکن آسیبپذیری اشتباه نگیر : اون درس درباره پیدا کردن نشونههای ضعف بود؛ اینجا اول داریم خودِ محیط و داراییها رو میشناسیم.
جمعآوری اطلاعات در هک به روش Passive و Active چه فرقی داره؟
شناسایی غیرفعال یا Passive Recon چطور انجام میشه؟
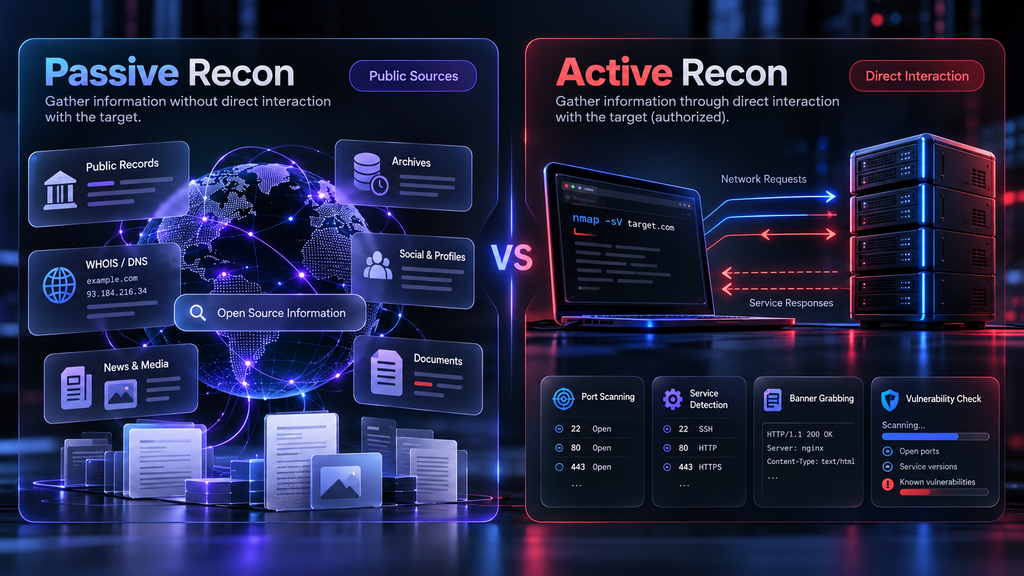
توی جمعآوری اطلاعات در هک وقتی میگیم Passive Recon یا شناسایی غیرفعال، معمولاً منظور اینه که برای پیدا کردن اطلاعات، مستقیم به خود سرویس هدف درخواست اکتشافی نفرستیم. مثلاً دادههای منتشرشده توسط مالک، سوابق عمومی یا اطلاعاتی رو که یه منبع ثالث قبلاً جمع کرده بررسی کنیم. اما اینجا یه دام وجود داره : هر چیزی که روی اینترنت قابل دیدنه، لزوماً مجوز جمعآوری انبوه، نگهداری یا انتشار دوباره نداره. حریم خصوصی و شرایط استفاده همچنان مهمن.
ضمن اینکه «غیرفعال» رو با «کاملاً نامرئی» یکی نگیر. سرویس واسطی که ازش داده میخونی ممکنه درخواستت رو ثبت کنه و اطلاعات خودش هم شاید قدیمی باشه. حتی بعضی سرویسها برای بهروزرسانی نتیجههاشون سراغ هدف میرن. پس هنگام جمعآوری اطلاعات در هک بهتره بدونی اطلاعاتت چه مسیری رو طی کرده و چه بخشش واقعاً مشاهدهست، نه اینکه صرفاً چون روی ابزار نوشته Passive خیال کنی هیچ اثری از کار باقی نمیمونه.
شناسایی فعال یا Active Recon چه فرقی داره؟
توی Active Recon فرق اصلی اینه که با خودِ داراییِ مجاز ارتباط برقرار میکنی. مثلاً روی سرور آزمایشگاهیای که مالک مشخص کرده، رفتار یه سرویس رو با درخواست محدود بررسی میکنی تا وضعیت فعلیش معلوم بشه. همین درخواست میتونه توی لاگ ثبت بشه یا روی سامانه بار بذاره؛ پس نوع بررسی، تعداد درخواستها، زمان اجرا و شرط توقف باید از قبل مشخص باشن. اسم «شناسایی» بهتنهایی کار رو بیخطر نمیکنه.
یه اشتباه رایج اینه که ابزارها رو دو ستون ثابت «Passive» و «Active» بچینیم و قضیه رو تمومشده بدونیم. یه ابزار ممکنه در یک حالت فقط از منبع ثالث داده بگیره و با گزینهای دیگه مستقیم به هدف درخواست بفرسته. باید تنظیمات و رفتار واقعی ابزار رو بشناسی. اگه نمیدونی یه دستور دقیقاً با کجا ارتباط میگیره، هنوز وقت اجرای اون روی سیستم مشتری نیست.
| ویژگی | غیرفعال (Passive) | فعال (Active) |
|---|---|---|
| منبع معمول | اطلاعات عمومی یا پایگاه ثالث | پاسخ مستقیم دارایی مجاز |
| تعامل مستقیم با هدف | معمولاً ندارد | دارد |
| ریسک عملیاتی | عمدتاً وابسته به داده و حریم خصوصی | وابسته به نرخ، روش، محیط و مجوز |
| محدودیت اصلی | قدیمی بودن و ناقص بودن داده | تأثیر بر سرویس و نیاز به هماهنگی |
| خروجی احتمالی | سرنخ و سابقه | مشاهده جاری از یک رفتار یا سرویس |
سناریوی اختصاصی : سطح حمله یک استودیوی پادکست رو چطور بشناسیم؟
برای درک بهتر جمعآوری اطلاعات در هک، بیایم استودیوی فرضی رو واضحتر تصور کنیم. سایت اصلی، برنامهها رو معرفی میکنه؛ اعضا از پنل جداگانه به اپیزودهای خریداریشده دسترسی دارن؛ فایل خام مهمانها داخل آرشیو خصوصی نگهداری میشه و پیامکها رو شرکت بیرونی ارسال میکنه. مدیر استودیو فقط بررسی کنترلشده محیط آزمایشی رو تأیید کرده. محیط اصلی، فایل صوتی واقعی و سرویس پیامک خارج از محدودهان. این تفاوتها رو از اول مینویسیم تا بعداً هیچ آدرسی رو با حدس به لیست اهداف مجاز اضافه نکنیم.
حالا تصور کن با آموزش جمعآوری اطلاعات در هک آشنا شدی و پنج اسم مرتبط با استودیو پیدا کردی. وسوسه میشی بنویسی «پنج هدف پیدا شد». ولی این نتیجهگیری عجولانهست. ممکنه دو مورد فقط سابقه تاریخی باشن یا به شرکت دیگهای تعلق داشته باشن. اول باید برای هر سرنخ، وضعیت تأیید و مجوز بررسی رو جدا ثبت کنی؛ جدول زیر دقیقاً همین کار رو انجام میده.
| دارایی فرضی | مشاهده اولیه | وضعیت مجوز | اقدام حرفهای |
|---|---|---|---|
| سایت عمومی استودیو | در فهرست اعلامشده مالک دیده میشه | مطالعه اطلاعات عمومی مجازه | ثبت اطلاعات و سؤال درباره تست فعال |
| پنل آزمایشی اعضا | مالک در جلسه فنی تأیید کرده | بررسی محدود با حساب ساختگی مجازه | شناخت نقشها و رفتار مورد انتظار |
| آرشیو فایلهای خام | نامش در مستند معماری هست | خارج از محدوده فعلی | بدون آزمون، فقط یادداشتِ وابستگی |
| سامانه پیامک | نام ارائهدهنده ثالث مشخصه | مجوزی ارائه نشده | توقف؛ درخواست شفافسازی مالکیت و مجوز |
| آدرس قدیمی پنل | در یک سابقه عمومی ثبت شده | وضعیت فعلی نامعلومه | برچسب قدیمی/تأییدنشده، نه سرویس فعال |
به جدول نگاه کن : از پنج سرنخ، فقط پنل آزمایشی برای بررسی فعال محدود مجوز روشن داره. سایت عمومی برای مطالعه دادههای عمومی مجازه، اما این یعنی اجازه اسکن سنگینش رو هم داریم؟ نه. آرشیو فایلها خارج از محدودهست و وضعیت پنل قدیمی هنوز نامعلومه. همین تفاوت نشون میده کیفیت Recon رو با تعداد آدرسها نمیسنجیم؛ با تصمیمهای درست و قابل دفاع میسنجیم.
در Recon چه نوع اطلاعاتی مهمتر از بقیه هستن؟
اینکه توی جمعآوری اطلاعات در تست نفوذ چه دادهای مهمتره، به هدف پروژه بستگی داره. اگه مسئله کنترل دسترسی اعضاست، شناخت نقشها و مسیر تبادل فایل مهمتر از صد تا نام قدیمیه. اگه پروژه درباره داراییهای اینترنتی شرکت باشه، دامنهها، گواهیها، سرویسهای آشکار و مرز ارائهدهندههای ثالث ارزش بیشتری پیدا میکنن. پس اول سؤال پروژه رو مشخص کن، بعد بگو چه اطلاعاتی لازم داری.
| دسته اطلاعات | چه کمکی میکنه؟ | احتیاط مهم |
|---|---|---|
| نامهای دامنه و زیردامنه | سرنخهایی از داراییها و محیطها میده | هر نام کشفشده هدف مجاز نیست |
| اطلاعات DNS | رابطه بعضی نامها و سرویسها رو روشن میکنه | رکورد بهتنهایی مالکیت یا فعالیت رو ثابت نمیکنه |
| گواهیهای دیجیتال | سرنخهایی از نامها یا زمان صدور میده | تاریخچه گواهی به معنی فعال بودن کنونی نیست |
| فناوری برنامه | برای فهم معماری و مسیر یادگیری مفیده | تشخیص فناوری میتونه ناقص یا اشتباه باشه |
| نقاط ورود برنامه | کمک میکنه جریانهای مجاز مشخص بشن | باید با حساب و Scope توافقشده بررسی بشن |
| سرویسهای ثالث | وابستگی و مرز مالکیت رو آشکار میکنه | بدون مجوز خود ارائهدهنده قابل آزمون نیست |
| اسناد عمومی | ممکنه توضیح معماری یا فرایندها رو بده | حریم خصوصی و شرایط استفاده اهمیت داره |
از جدول بالا میشه یه قانون ساده درآورد : برای هر دسته اطلاعات بپرس «این مورد به چه دردی میخوره و چطور ممکنه اشتباه تفسیر بشه؟» مثلاً گواهی دیجیتال میتونه وجود یه نام رو در گذشته نشون بده، ولی فعال بودن اون سرویس رو در همین لحظه ثابت نمیکنه. اگه نتونی از خروجی ابزار چنین توضیحی بدی، احتمالاً صرفاً یه فهرست قشنگ تولید کردی. هدف این مقاله هم یاد دادن همین تحلیل اولیهست، نه جایگزین شدن با آموزش عملی تکتک ابزارها.
DNS توی جمعآوری اطلاعات چه کمکی میکنه؟
ببین، توی جمعآوری اطلاعات در هک، DNS فقط دفترچه تبدیل اسم سایت به IP نیست. رکوردهای مختلفش میتونن سرنخهایی درباره ایمیل، سرویسهای وابسته یا الگوی نامگذاری سیستمها بدن. مثلاً شاید از اطلاعات DNS حدس بزنی یه زیردامنه برای سرویس ایمیل استفاده شده. اما یادت باشه رکورد DNS بهتنهایی نه مالکیت قطعی رو ثابت میکنه، نه زنده بودن سرویس رو و نه مجوز بررسی رو. برای هر نتیجه جدی باید منبع و وضعیت فعلی رو جداگانه بسنجیم.
خیلیها توی جمعآوری اطلاعات در هک دنبال رکورد زدن تعداد زیردامنهان. ولی ممکنه یه مجموعه سالها نامهای بلااستفاده داشته باشه یا از CDN و هاست مشترک استفاده کنه. بهتره کنار هر نام، تاریخ مشاهده، منبع و وضعیت تأیید رو ثبت کنی. اونوقت وقتی مدیر پروژه میپرسه «این پنل هنوز برای ماست؟»، بهجای اینکه با اطمینان الکی جواب بدی، میتونی نشون بدی کدوم بخش رو میدونی و کدوم بخش نیاز به بررسی داره.
برای دیدن جزئیات تخصصی این موضوع، راهنمای رسمی OWASP درباره Attack Surface Identification رو ببین. این راهنما توضیح میده چطور نامهای دامنه، میزبانهای مجازی و گواهیها به شناخت سطح حمله کمک میکنن و چرا یک IP ممکنه چند برنامه متفاوت رو میزبانی کنه. ما اینجا فقط مفهوم رو میگیریم؛ هر روش عملی باید در محدوده و با مجوز مناسب انتخاب بشه.
OSINT یعنی هر اطلاعات عمومی رو میشه آزادانه جمع کرد؟
نه، توی جمعآوری اطلاعات در هک، OSINT به معنی «هرچی توی اینترنت دیدی آزادانه جمع کن» نیست. اگه میپرسی «OSINT چیست؟»، OSINT یا اطلاعات منبعباز یعنی با منابع در دسترس عمومی یا مجاز کار کنی و از دادهها نتیجه قابل اتکا بگیری. ولی ممکنه یه سند اتفاقی منتشر شده باشه یا اطلاعات شخصی افراد داخلش دیده بشه. اینکه فایل بدون رمز باز میشه به معنی اجازه دانلود انبوه، بازنشر یا استفاده خارج از توافق نیست. حداقل داده لازم رو بردار و محدودیت محرمانگی رو رعایت کن.
برای مثال، اگه یه مستند عمومی اسم شرکت میزبان فایلهای استودیو رو نشون داد، میتونی این وابستگی رو توی نقشهات ثبت کنی. اما این اطلاعات مجوز رفتن به فایلهای مهمانها یا حسابهای دیگران رو ایجاد نمیکنه. توی درس هک اخلاقی چیست؟ درباره همین مرز حرف زدیم : دسترسیپذیر بودن یه چیز با مجاز بودن بررسیش فرق داره. این اصل حتی توی شناسایی غیرفعال هم باید رعایت بشه.
سطح حمله یا Attack Surface چیه و چه ربطی به هک سایت داره؟
توی جمعآوری اطلاعات در هک وقتی میشنوی Attack Surface یا سطح حمله، تصور کن داریم همه راههایی رو پیدا میکنیم که سیستم از طریق اونها ورودی میگیره یا با بخشهای دیگه در ارتباطه. توی یه وباپلیکیشن، صفحه ورود، API، آپلود فایل، پنلهای مختلف و بعضی سرویسهای وابسته میتونن بخشی از این تصویر باشن. اما هر نقطه ورود، آسیبپذیری نیست. فعلاً داریم میفهمیم چه چیزهایی وجود دارن؛ آزمودن امن بودن هرکدوم سؤال مرحله بعده.
مثلاً توی استودیوی ما، گوش دادن به اپیزود و آپلود فایل خام دو جریان کاملاً متفاوتن. شاید عضو عادی اجازه شنیدن بعضی اپیزودها رو داشته باشه، ولی آپلود باید فقط برای تدوینگر فعال باشه. اگه توی نقشه صرفاً دو آدرس URL بنویسیم، اصل ماجرا گم میشه. باید کنار هر مسیر، نقش کاربر، نوع داده و وضعیت مجوز آزمون رو هم بفهمیم. اونوقت نقشه برای تیم توسعه واقعاً قابل استفاده میشه.
اگه تمرکزت روی شناسایی هدف در هک و امنیت وب باشه، این نقشه بعداً موقع بررسی احراز هویت و کنترل دسترسی خیلی به دردت میخوره. ولی این درس قرار نیست هر API پیداشده رو تبدیل به هدف حمله کنه. درباره آزمونهای اختصاصی وب توی مسیر امنیت وب نابغهها جدا صحبت میکنیم. فعلاً یاد بگیر فرق «این مسیر وجود داره» با «این مسیر ضعف داره» رو دقیق نگه داری.
تفاوت مشاهده، فرضیه و یافته تأییدشده در Recon
یه اشتباه بزرگ در جمعآوری اطلاعات در هک اینه که از یه سرنخ، چند پله نتیجهگیری کنیم. فرض کن توی یه آرشیو اسم old-panel دیده میشه. چیزی که واقعاً مشاهده کردی اینه : «این نام در یه منبع تاریخی ثبت شده». اینکه «شاید الان فعاله» یه فرضیهست و اینکه «آسیبپذیره» اصلاً از این دو جمله درنمیاد. حتی اگه مالک بگه پنل هنوز وجود داره، باید جدا مشخص کنه آیا اجازه آزمودنش رو هم داریم یا نه.
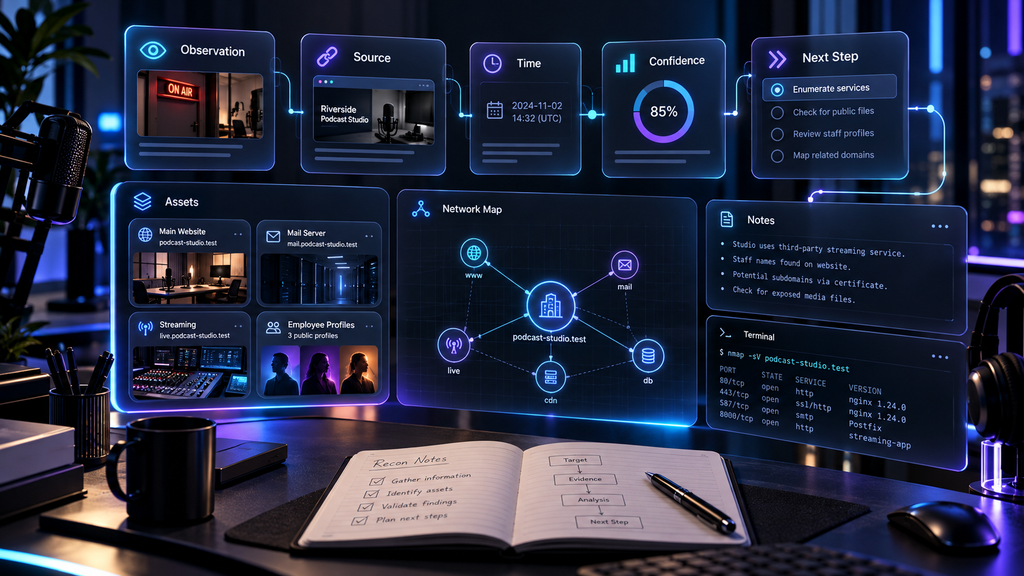
برای اینکه این مرزها قاطی نشن، توی این درس یه روش آموزشی به اسم «دفترچه شواهد» داریم. اسمش استاندارد رسمی نیست؛ فقط یه راه سادهست برای مرتب کردن ذهن. هر سرنخ رو با پنج چیز ثبت میکنیم : چی دیدم؟ از کجا دیدم؟ چه زمانی ثبت شده؟ چقدر بهش مطمئنم؟ قدم مجاز بعدی چیه؟ بهنظرم هر کسی دنبال آموزش Recon باشه باید قبل از حفظ کردن دستورها، بتونه یه دفترچه شواهد قابل فهم درست کنه.
| مورد دفترچه | سؤال مناسب | نمونه در استودیوی فرضی |
|---|---|---|
| مشاهده | دقیقاً چه چیزی دیدیم؟ | یک نام محیط آزمایشی در سند قدیمی دیده شده |
| منبع | این ادعا از کجا اومده؟ | سند داخلیِ مجاز یا فهرست عمومی |
| زمان | این اطلاعات مربوط به کیه؟ | تاریخ انتشار سند، نه زمان فعالیت سرویس |
| اطمینان | چه چیزی تأیید و چه چیزی نامعلومه؟ | نام مشاهده شده؛ فعال بودن هنوز تأیید نشده |
| تصمیم بعدی | با توجه به Scope باید چه کنیم؟ | از مالک درباره وضعیت و مجوز سؤال بپرسیم |
خوبی این روش وقتی مشخص میشه که تیم استودیو یه هفته بعد جواب بده «اون پنل قدیمی رو شش ماه پیش حذف کردیم». حالا دقیق میفهمی کدوم داده قدیمی بوده و چرا باید وضعیتش عوض بشه. ضمن اینکه با جمعآوری اطلاعات در هک قرار نیست فقط برای خودت یادداشت برداری؛ یه نفر دیگه هم باید بتونه شواهد رو ببینه و بفهمه نتیجهات از کجا اومده. همین تفاوت یه فهرست خام با یه گزارش حرفهایه.
چرا دادههای Recon ممکنه اشتباه یا قدیمی باشن؟
اطلاعاتی که در جمعآوری اطلاعات در هک به دست میاری، تاریخ انقضا دارن. سرویسها جابهجا میشن، شرکتها زیرساختشون رو عوض میکنن، رکوردهای DNS تغییر میکنن و حتی ممکنه یه دامنه قدیمی به مالک جدیدی رسیده باشه. بنابراین دادهای که سال قبل درست بوده، شاید امروز حتی به همون سازمان هم مربوط نباشه. اگه دو منبع با هم اختلاف دارن، بهجای اینکه سریع یکی رو اشتباه اعلام کنی، تاریخ ثبت و روش جمعآوری هرکدوم رو مقایسه کن.
برای نمونه، وجود یه نام داخل گواهی قدیمی فقط نشون میده اون نام زمانی توی فرایند صدور گواهی مطرح بوده؛ نه اینکه امروز سرویس پاسخ بده. همینطور یه IP مشترک ممکنه پشت چند سایت بیربط باشه. پس توی جمعآوری اطلاعات در هک نباید از شباهت فنی به مالکیت قطعی بپری. هرجا داده کافی نداریم، صادقانه مینویسیم «نیازمند تأیید»؛ این خیلی حرفهایتر از یه نمودار پرجزئیاته که پایههای اشتباهی داره.
آیا جمعآوری اطلاعات همون اسکن پورت و آسیبپذیریه؟
نه، Recon همون اسکن پورت یا اسکن آسیبپذیری نیست. اسکن میتونه یکی از روشهای شناخت محیط باشه، ولی بهتنهایی نمیگه این سرور برای چه کاری استفاده میشه، مال کیه یا اجازه آزمودنش رو داری یا نه. اسکنر آسیبپذیری هم دنبال نشونههای ضعف میگرده؛ درحالیکه ما اینجا بیشتر داریم داراییها و ارتباطشون رو میشناسیم. اگه هنوز این دوتا رو یکی میبینی، درس تفاوت اسکن آسیبپذیری و تست نفوذ رو کنار این بخش بخون.
پس برای آموزش جمعآوری اطلاعات در تست نفوذ لازم نیست اولین حرکتت اجرای Nmap باشه. شاید از مالک یه فهرست سرویس بگیری و همون کافی باشه تا چند ابهام مهم رو پیدا کنی. اگه بعداً بررسی فعال لازم شد، با مجوز مشخص انجامش میدی. مستندات رسمی Nmap درباره Host Discovery هم نشون میده نوع درخواستها چقدر به گزینههای ابزار وابستهست؛ انتخاب دستور بدون فهم ترافیکش تصمیم خوبی نیست.
ابزارهای جمعآوری اطلاعات و آموزش Recon از کجا شروع میشن؟
وقتی برای جمعآوری اطلاعات در هک دنبال ابزارهای جمعآوری اطلاعات میگردی، اسمهای زیادی میبینی؛ از Subfinder و Amass گرفته تا Nmap و Burp Suite. بهجای اینکه همه رو یکجا نصب کنی، اول ابزارها رو براساس سؤال دستهبندی کن. میخوای نامهای مرتبط رو بشناسی؟ سوابق تاریخی رو ببینی؟ فناوری یه سرویس مجاز رو تشخیص بدی؟ یا جریان درخواست و پاسخ یه برنامه آزمایشی رو بفهمی؟ هر هدف ابزار مناسب خودش رو داره و هر ابزار هم ممکنه خطا کنه.
| ابزار / منبع شناختهشده | کاربرد کلی | سوءبرداشت رایج |
|---|---|---|
| Subfinder و Amass | یافتن نامهای مرتبط از منابع مختلف بر اساس تنظیمات | هر زیردامنه یافتهشده، هدف مجاز و فعال است |
| اطلاعات DNS و گواهیها | شناخت برخی نامها و وابستگیها | هر نام در گواهی الان زنده و متعلق به هدف است |
| منابع آرشیوی وب | مشاهده برخی مسیرها و صفحات تاریخی | هر URL قدیمی هنوز قابل دسترسی است |
| Nmap | شناخت سرویسهای شبکه در حالت اسکن مجاز | پورت باز یعنی آسیبپذیری قطعی |
| Burp Suite | کمک به مشاهده جریان درخواست و پاسخ در برنامه مجاز | خودکار تمام ضعفهای منطق برنامه را پیدا میکند |
| منابع جستوجوی عمومی | پیدا کردن اطلاعاتی که قبلاً منتشر شده | هر اطلاعات عمومی مجوز تست یا انتشار دوباره میدهد |
یه نکته مهم درباره ابزارهای Recon اینه که بعضیها بسته به تنظیمات میتونن با خود هدف ارتباط مستقیم داشته باشن. پس حتی اگر یه ابزار بین بچههای امنیت به «پسیو» معروفه، رفتار نسخه و گزینهای که استفاده میکنی رو بررسی کن. جدول بالا فقط کمک میکنه جای هر خانواده ابزار رو بفهمی؛ دستورهای عملی باید توی آزمایشگاه شخصی یا محیطی با مجوز روشن تست بشن. اسم ابزار هم بهخودیخود مدرک درست بودن خروجیش نیست.
تمرین آفلاین پایتون : مرتب کردن سرنخهای Recon بدون اسکن شبکه
حالا برای اینکه جمعآوری اطلاعات در هک فقط یه تعریف نباشه، یه تمرین واقعیِ آفلاین انجام بدیم؛ واقعی از این نظر که کد رو اجرا میکنیم، نه اینکه به سایتی حمله کنیم. یه فهرست ساختگی از داراییهای استودیو داریم و برای هر مورد دو ویژگی ثبت شده : آیا وجود و نسبت اون به مجموعه تأیید شده، و آیا دارایی داخل محدوده ارزیابی هست یا نه. میخوایم فقط برای مرتبکردن یادداشتها یه پیشنهاد محافظهکارانه چاپ کنیم. برنامه مجوز حقوقی صادر نمیکنه و هیچ اسکن یا درخواستی نمیفرسته.
assets = [
    {"name": "public_site", "confirmed": True, "in_scope": True},
    {"name": "test_portal", "confirmed": True, "in_scope": True},
    {"name": "audio_archive", "confirmed": True, "in_scope": False},
    {"name": "sms_provider", "confirmed": False, "in_scope": False},
    {"name": "old_panel", "confirmed": False, "in_scope": False},
]


def decide(asset):
    if not isinstance(asset, dict):
        return "manual review; do not test"

    confirmed = asset.get("confirmed")
    in_scope = asset.get("in_scope")

    # A non-empty string such as "false" is truthy in Python.
    # Only actual Boolean values are accepted in this toy model.
    if type(confirmed) is not bool or type(in_scope) is not bool:
        return "manual review; do not test"

    if not confirmed:
        return "ask owner; do not test"
    if not in_scope:
        return "record only; out of scope"
    return "consult approved ROE; no automatic test"


for asset in assets:
    print(asset["name"], "->", decide(asset))
خروجی واقعی برنامه روی دادههای فرضی بالا اینه :
public_site -> consult approved ROE; no automatic test
test_portal -> consult approved ROE; no automatic test
audio_archive -> record only; out of scope
sms_provider -> ask owner; do not test
old_panel -> ask owner; do not test
دقت کن دو مورد اول فقط میگن «برای اقدام بعدی، قواعد مصوب رو بخون»؛ نمیگن «اسکن کن». چون حتی وقتی یه دارایی واقعاً وجود داره و داخل محدودهست، هنوز روش مجاز، زمان اجرا، حسابهای آزمایشی و میزان تعامل رو باید از قرارداد بفهمیم. اگه اطلاعات یه رکورد ناقص باشه یا مقدار متنی بهجای بولی واردش کنیم، نسخه جدید کد بهجای تأیید اشتباه، اون رو برای بررسی دستی کنار میذاره. چنین احتیاطی توی تصمیمهای امنیتی خیلی مهمه.
هفت اشتباه رایج در جمعآوری اطلاعات برای هک قانونی
اشتباه اول : تعداد زیردامنهها رو معادل پیشرفت بدونیم
فرض کن یه ابزار ۴۰۰ زیردامنه نشون داده. قبل از اینکه ذوق کنی، بپرس چندتاش تکراریه، چندتاش از آرشیو قدیمی اومده و چندتاش واقعاً به محیط مجاز مربوطه. ممکنه بعد از پالایش، فقط ده مدخل به درد پروژه بخوره. اون ده مورد قابل اتکا از یه فایل شلوغ ارزش بیشتری دارن، چون میتونی براشون توضیح و مدرک بیاری.
اشتباه دوم : هر چیزی روی یک IP بود، متعلق به یک مالک بدونیم
یه خطای رایج دیگه در جمعآوری اطلاعات در هک اینه که بگیم «این سایتها روی یه IP هستن، پس همهشون برای یه شرکتن». هاست اشتراکی و CDN میتونن سایتهای کاملاً بیربط رو پشت یه آدرس نشون بدن. این سرنخ فنی نه سند مالکیت محسوب میشه و نه مجوز آزمون. اگه درباره مالک یا محدوده شک داری، از صاحب پروژه سؤال بپرس؛ با اجرای اسکن بیشتر نمیشه مجوز حقوقی تولید کرد.
اشتباه سوم : اطلاعات قدیمی رو وضعیت فعلی گزارش کنیم
وقتی یه نام رو از آرشیو پیدا میکنی، تاریخش رو هم کنارش ثبت کن. اینکه یه صفحه سال قبل وجود داشته، دلیل نمیشه همین امروز فعال باشه. گزارش حرفهای این تفاوت رو روشن میکنه : «در منبع تاریخی دیده شده» با «در محیط آزمایشی مجاز تأیید شده» دو سطح از اطمینان متفاوتن.
اشتباه چهارم : Passive رو معادل بینیازی از رعایت قانون بگیریم
حتی اگه اطلاعات از یه صفحه عمومی اومده، ممکنه شامل داده شخصی یا شرایط استفاده محدود باشه. برای همین جمعآوری بیحسابوکتاب اسم افراد، ایمیلها یا فایلهای حساس کار درستی نیست. فقط چیزی رو نگه دار که برای هدف توافقشده لازمه و برای اشتراکگذاریش هم مجوز داری. روش Passive قرار نیست بهانهای برای کنار گذاشتن حریم خصوصی بشه.
اشتباه پنجم : نام ابزار رو با اثبات آسیبپذیری اشتباه بگیریم
توی جمعآوری اطلاعات در هک، اگه Nmap بهت گفت یه پورت بازه، فقط همین رو فعلاً ثبت کن؛ لازم نیست اسمش رو بذاری «باگ قطعی». اگه یه صفحه تاریخی هم یه مسیر قدیمی نشون داد، هنوز نمیدونی الان وجود داره یا نه. تفاوت متخصص با کسی که فقط خروجی ابزار رو کپی میکنه، دقیقاً توی همین اندازهگیری ادعا با شواهده.
اشتباه ششم : محدوده توافق رو وسط کار خودمون بزرگ کنیم
گاهی موقع Recon یه سرویس تازه پیدا میکنی و دلت میخواد همون لحظه امتحانش کنی. اما اگه داخل Scope نباشه، باید متوقف بشی و با مسئول پروژه هماهنگ کنی. پیدا کردن یه دارایی جدید فقط یه سرنخ جدیده؛ اجازه جدید نیست. مخصوصاً برای سرویسهای شرکت ثالث این اشتباه میتونه دردسر جدی درست کنه.
اشتباه هفتم : بدون سؤال مشخص از ده ابزار خروجی بگیریم
قبل از اجرای هر ابزار سه سؤال بپرس : «دنبال جواب چه پرسشیام؟»، «این ابزار واقعاً چه اطلاعاتی تولید میکنه؟» و «چطور نتیجهاش رو تأیید میکنم؟». اگه این سه تا رو نمیدونی، شاید بهتر باشه فعلاً سراغ مستندات و شفافسازی Scope بری. آموزش هک و تست نفوذ از فهم سؤال شروع میشه، نه از مسابقه تعداد فرمانهای ترمینال.
گزارش Recon رو چطور بنویسیم که واقعاً به درد بخوره؟
گزارش جمعآوری اطلاعات در هک قرار نیست آلبوم اسکرینشات ترمینال باشه. کسی که بعداً گزارش رو میخونه باید بفهمه چه داراییهایی پیدا شدن، ارتباط هرکدوم چیه، اطلاعات از کجا اومده و کجا هنوز ابهام داریم. برای مدیر، نتیجه باید به تصمیم کمک کنه؛ مثلاً تکمیل فهرست داراییها یا روشنکردن مالکیت یه سرویس. برای تیم فنی هم باید شواهد و محدودیتها مشخص باشن تا بیدلیل روی یه حدس وقت نذارن.
توی استودیوی فرضی میتونیم نتیجه رو اینطوری بنویسیم : «پنج سرنخ مرتبط ثبت شد؛ برای یک پنل آزمایشی مجوز بررسی محدود داریم، سایت عمومی فقط برای مطالعه اطلاعات عمومی مشخص شده، یک آرشیو صریحاً خارج از محدودهست و دو مدخل هنوز نیازمند شفافسازیان». این جمعبندی نه ادعای نفوذ داره، نه وانمود میکنه همه داراییها کشف شدهان. ولی قدم بعدی رو برای صاحب پروژه روشن میکنه؛ این یعنی گزارش Recon به درد تصمیم میخوره.
| بخش گزارش | چیزی که باید ثبت بشه |
|---|---|
| هدف و Scope | دامنه توافقشده و محدودیتهای اجرا |
| فهرست دارایی | نام قابل تشخیص و نقش احتمالی هر بخش |
| منبع و زمان | منشأ مشاهده و تاریخ داده |
| درجه اطمینان | تأییدشده، احتمالی یا قدیمی |
| مرز مالکیت | دارایی داخلی، وابسته به ثالث یا نامعلوم |
| اقدام بعدی | نیاز به تأیید مالک، تکمیل اسناد یا آزمون مجاز |
| آنچه بررسی نشد | محدودیت زمانی، روشی یا حقوقی |
از کجا بفهمیم جمعآوری اطلاعات کافی شده و باید توقف کنیم؟
ممکنه توی جمعآوری اطلاعات در هک هرچقدر بیشتر بگردی، باز هم اسم تازه پیدا بشه. ولی پروژه زمان نامحدود نداره. از اول مشخص کن برای شروع مرحله بعد چه چیزهایی رو باید بدونی : داراییهای اصلی کدوما هستن؟ ابهامهای مهم به مالک ارجاع داده شدن؟ حد و مرز بررسی روشنه؟ اگه جوابها کافی بود، لازم نیست فقط برای بزرگتر شدن فایل خروجی وقت بیشتری مصرف کنی. اگر وسط کار وابستگی مهم تازهای پیدا شد، دوباره با مسئول پروژه هماهنگ میکنی.
یه وقتهایی لازمه بعد از شروع بررسی فنی، دوباره به Recon برگردی؛ مثلاً وقتی میفهمی یه مسیر درخواست از سرویس دیگری استفاده میکنه. این برگشت طبیعیه، اما اضافه شدن دارایی یا تغییر نوع آزمون باید مجوز تازه داشته باشه. اگه میخوای جای این مرحله رو توی کل پروژه ببینی، درس مراحل تست نفوذ رو بخون؛ اونجا از آغاز قرارداد تا گزارش و Retest صحبت کردیم.
هوش مصنوعی در Recon کمک میکنه یا باعث اشتباه میشه؟
هوش مصنوعی میتونه در جمعآوری اطلاعات در هک، توی مرتبسازی یادداشتها کمک کنه؛ مثلاً گزارش آزمایشی رو به سه دسته «مشاهده»، «فرضیه» و «نیازمند تأیید» تقسیم کنه یا سؤالهای بیجواب رو از متن بیرون بکشه. ولی اگه یه مدل با اطمینان بگه «این پنل فعاله»، از کجا فهمیده؟ بدون منبع و بررسی معتبر، اون هم فقط یه ادعاست. توی جمعآوری اطلاعات در هک نباید پاسخ روان و مطمئن رو با شاهد واقعی اشتباه بگیری.
قبل از اینکه مستند معماری مشتری یا اطلاعات اعضا رو داخل یه ابزار هوش مصنوعی بفرستی، باید ببینی قرارداد و سیاست محرمانگی اجازه میده یا نه. حتی اگه اسمها رو حذف کردی، ممکنه ترکیب جزئیات فنی همچنان حساس باشه. برای تمرین میتونی از دادههای ساختگی همین درس استفاده کنی. ابزار کمکیه؛ مسئولیت تعیین Scope، رعایت حریم خصوصی و تأیید ادعا همچنان با انسانه.
برای یادگیری جمعآوری اطلاعات در هک چه پیشنیازهایی لازمه؟
برای شروع آموزش جمعآوری اطلاعات در هک قرار نیست همه چیز رو از بر باشی، ولی چند تا پایه واقعاً لازمه : دامنه و DNS چطور کار میکنن، IP و پورت چه فرقی دارن، یه درخواست HTTP چطور به سرور میرسه و مجوز آزمون دقیقاً چه معنایی داره. وقتی اینها رو بفهمی، خروجی ابزار برات فقط یه جدول رنگی نیست؛ میتونی بگی کدوم قسمت مشاهده شده و کدومش نیاز به بررسی داره.
اگه تازه وارد حوزه شدی، اول مبانی هک و امنیت رو مرور کن و بعد از مسیر آموزش تست نفوذ جلو برو. برای تمرینهای ساختارمندتر و کار با ابزارها توی محیط مجاز هم میتونی سرفصلهای پکیج متخصص تست نفوذ نابغهها رو ببینی. قرار نیست این مقاله جای آموزش عملی همه ابزارها رو بگیره؛ قرار اینه وقتی سراغ اون ابزارها رفتی، دقیقاً بدونی دنبال چه جوابی هستی.
سه تمرین تحلیلی : آیا اطلاعات کافی برای تصمیم داریم؟
تمرین اول : نام قدیمی یا سرویس فعال؟
برای تمرین جمعآوری اطلاعات در هک فرض کن توی یه آرشیو عمومی اسم پنل تدوین استودیو رو دیدی، ولی هیچکس وضعیت فعلیش رو تأیید نکرده. آیا میتونی بنویسی «پنل فعاله و قابل نفوذه»؟ نه. چیزی که داری فقط یه مشاهده تاریخیه. منبع و تاریخ رو ثبت کن و برای تشخیص وضعیت فعلی، طبق محدوده پروژه از مالک سؤال بپرس. نتیجهگیری اضافه از روی یه نام قدیمی، گزارش رو غیرقابل اعتماد میکنه.
تمرین دوم : نام مشابه و مالکیت متفاوت
دو تا سرویس اسم برند یکسانی دارن، اما یکیشون روی زیرساخت شرکت بیرونی اجرا میشه. آیا چون برندشون یکیه، هر دو رو میشه تست کرد؟ نه. باید روشن بشه مالک فنی کیه، قرارداد چه محدودهای رو پوشش میده و چه کسی اختیار مجوز دادن داره. ظاهر مشابه یا اتصال بین سرویسها، این اجازه رو خودکار ایجاد نمیکنه.
تمرین سوم : تعداد دارایی بیشتر یا شناخت دقیقتر؟
ابزار اول ۲۵۰ اسم تحویلت داده که معلوم نیست چندتاشون معتبرن؛ گزارش دوم فقط هشت دارایی داره ولی برای هرکدوم منبع، زمان، نقش و وضعیت مجوز مشخصه. کدوم برای شروع یه پروژه محدود بهتره؟ معمولاً دومی، چون میتونی بر اساسش تصمیم بگیری. البته فهرست اول هم ممکنه منبع سرنخ باشه؛ فقط نباید اون رو نقشه قطعی محیط معرفی کنی.
سؤالات متداول درباره جمعآوری اطلاعات در هک
جمعآوری اطلاعات در هک چیست؟
خیلی ساده : جمعآوری اطلاعات در هک یعنی شناخت داراییها، سرویسها و ارتباطهای یک محیط و مشخصکردن میزان اطمینان به اطلاعات، در چارچوب مجوز. خروجی خوب یه نقشه قابل پیگیریه؛ نه لزوماً پیدا کردن آسیبپذیری یا وارد شدن به سیستم.
Reconnaissance در تست نفوذ چه مرحلهایه؟
مرحله Recon یا Reconnaissance معمولاً بخشی از شناخت و کشف محیطه که پیش از آزمونهای عمیقتر انجام میشه؛ البته ممکنه در طول پروژه دوباره بهش برگردیم. اسم و ترتیب مرحلهها در متدولوژیهای مختلف فرق میکنه، ولی هدف ثابت میمونه : کم کردن ابهام قبل از تصمیم فنی.
تفاوت Passive Recon و Active Recon چیه؟
توی Passive Recon بیشتر سراغ منابع عمومی یا دادههای ثبتشده توسط سرویس ثالث میریم؛ توی Active Recon مستقیم با داراییِ مجاز تعامل داریم. از نظر میزان اثر و ردپا متفاوتن، ولی هیچکدوم بدون توجه به قوانین و محدوده پروژه مجاز تلقی نمیشن.
OSINT همون هک کردنه؟
نه. OSINT یعنی استفاده تحلیلی از اطلاعات در دسترس عمومی یا مجاز. این کار میتونه به شناخت محیط کمک کنه، اما با دیدن یه نام، نه ضعف امنیتی اثبات میشه و نه اجازه تست روی اون سرویس به دست میاد.
برای جمعآوری اطلاعات حتماً باید کالی لینوکس نصب کنیم؟
نه، نصب کالی لینوکس شرط یاد گرفتن این موضوع نیست. بهتره اول DNS، وب، شبکه و تفاوت مشاهده با فرضیه رو بفهمی. بعد میتونی توی آزمایشگاه مجاز با ابزارهای مربوط تمرین کنی و خروجیها رو درست تفسیر کنی.
آیا هر زیردامنه پیداشده جزو اهداف مجازه؟
نه. یه زیردامنه ممکنه قدیمی، وابسته به شرکت ثالث یا خارج از Scope باشه. قبل از بررسی مستقیم باید مالکیت، وضعیت فعلی و اجازه روش آزمون روشن باشه. اسم پیداشده بهتنهایی مجوز جدید نیست.
آیا جمعآوری اطلاعات با Nmap همون اسکن آسیبپذیریه؟
نه. Nmap میتونه روی میزبانهای مجاز اطلاعاتی درباره در دسترس بودن و سرویسها بده، ولی Recon فقط اسکن نیست. از طرفی یه پورت باز هم بهتنهایی نمیگه سرویس آسیبپذیره.
آیا هوش مصنوعی میتونه Recon رو کامل انجام بده؟
میتونه یادداشتها رو مرتب کنه و سؤالهای ناقص رو نشون بده؛ ولی خودش نه مالکیت یه سرویس رو اثبات میکنه، نه مجوز میده و نه تازه بودن اطلاعات رو تضمین میکنه. برای هر نتیجه مهم باید منبع و تأیید انسانی داشته باشی.
منابع معتبر برای مطالعه بیشتر
اگه میخوای جواب سؤال «Reconnaissance چیست؟» رو از منابع رسمی هم بررسی کنی، از راهنمای NIST SP 800-115 و بخش Information Gathering در OWASP WSTG شروع کن. برای بحث سطح حمله و نقاط ورود هم شناسایی سطح حمله و شناسایی نقاط ورود وباپلیکیشن رو ببین. همچنین MITRE ATT&CK درباره Reconnaissance نشون میده مهاجمها چطور از جمعآوری اطلاعات برای برنامهریزی استفاده میکنن؛ این بخش توصیف رفتار تهدیده، نه مجوز انجام اون. مثالهای استودیو و دفترچه شواهد همگی مخصوص همین درس و ساختگیان.
جمعبندی : قبل از ابزار، هدف و مجوز رو درست بشناس
اگه بخوام کل درس رو توی یه جمله جمع کنم، میگم : قبل از اینکه چیزی رو تست کنی، مطمئن شو میدونی اون چیز چیه و اجازه چه کاری رو داری. توی جمعآوری اطلاعات در هک یاد گرفتیم پیدا شدن یه زیردامنه دلیل فعال بودنش نیست، داشتن IP مشترک اثبات مالکیت نیست و خروجی ابزار هم سند آسیبپذیری قطعی محسوب نمیشه. با دفترچه شواهد هم دیدیم چطور از یه فهرست پراکنده، تصمیمی بسازیم که فرد دیگهای هم بتونه بررسیش کنه.
برای ادامه، میتونی از هاب آموزش تست نفوذ بری سراغ درسهای مرتبط و وقتی خواستی با ابزارها کار کنی، تمرینهات رو توی محیط مجاز جلو ببری. اگه آموزش ویدیویی و تمرین مرحلهای میخوای، سرفصلها و نمونههای پکیج متخصص تست نفوذ رو هم بررسی کن. هدف این درس اینه که خروجی هر ابزار رو با سؤال درست بسنجی؛ مهارت واقعی با تحلیل، آزمون مسئولانه و اصلاح اشتباهها ساخته میشه.